神经网络的训练本质上是一个优化问题:我们希望找到一组参数,使得损失函数尽可能小。上一篇文章介绍了梯度下降的基本思想:沿着梯度方向更新参数。本文将从最简单的SGD开始,逐步介绍各种优化算法,并延伸到2024-2025年大模型训练中最新、最常用的优化器。
优化算法的统一框架
在开始之前,先用一个统一的视角来理解所有优化算法。无论算法多么复杂,它们的核心思想都可以归结为解决两个问题:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| ┌─────────────────────────────────────────────────────────────┐
│ 优化算法的两大核心问题 │
├─────────────────────────────────────────────────────────────┤
│ │
│ 问题1:梯度噪声大,方向不稳定 │
│ → 解决方案:一阶动量(First-Order Momentum) │
│ → 代表算法:SGD+Momentum, Nesterov │
│ │
│ 问题2:不同参数需要不同的学习率 │
│ → 解决方案:自适应学习率(Adaptive Learning Rate) │
│ → 代表算法:AdaGrad, RMSProp, Adam │
│ │
│ 两者结合 → Adam = 一阶动量 + 自适应学习率 │
│ │
└─────────────────────────────────────────────────────────────┘
|
统一更新公式
所有现代优化算法都可以用以下公式来表达:
θt=θt−1−st+ϵη⋅mt
这个公式包含三个核心组件:
| 组件 |
符号 |
作用 |
解决的问题 |
| 一阶动量 |
mt |
梯度的平滑估计 |
梯度噪声,方向不稳定 |
| 二阶矩(自适应学习率) |
st |
每个参数独立的学习率缩放 |
不同参数需要不同学习率 |
| 基础学习率 |
η |
全局的学习率缩放 |
控制更新幅度 |
直观理解:
- mt 像一个"指南针",告诉我们往哪个方向走(平滑后的梯度方向)
- st 像一个"地形图",告诉我们每一步该走多大(根据历史梯度自适应调整)
- η 像一个"步幅系数",控制整体的移动速度
不同的优化算法,只是对 mt 和 st 的不同实现方式。让我们从最简单的开始,逐步添加这两个组件。
1. SGD:最基础的优化器
1.1 定义
SGD(Stochastic Gradient Descent,随机梯度下降)是最基础的优化算法。它没有使用任何动量或自适应学习率,直接用当前梯度更新参数:
θt=θt−1−η⋅gt
其中 θt 是参数,gt 是当前batch的梯度,η 是学习率。
在统一框架下的表示:
θt=θt−1−st+ϵη⋅mt⋅gt
SGD没有一阶动量(mt)和二阶矩(st),直接用梯度 gt 更新。
代码实现:
1
2
3
4
5
6
7
8
| class SGD:
def __init__(self, params, lr=0.01):
self.params = params
self.lr = lr
def step(self):
for param in self.params:
param.data -= self.lr * param.grad
|
1.2 直观理解
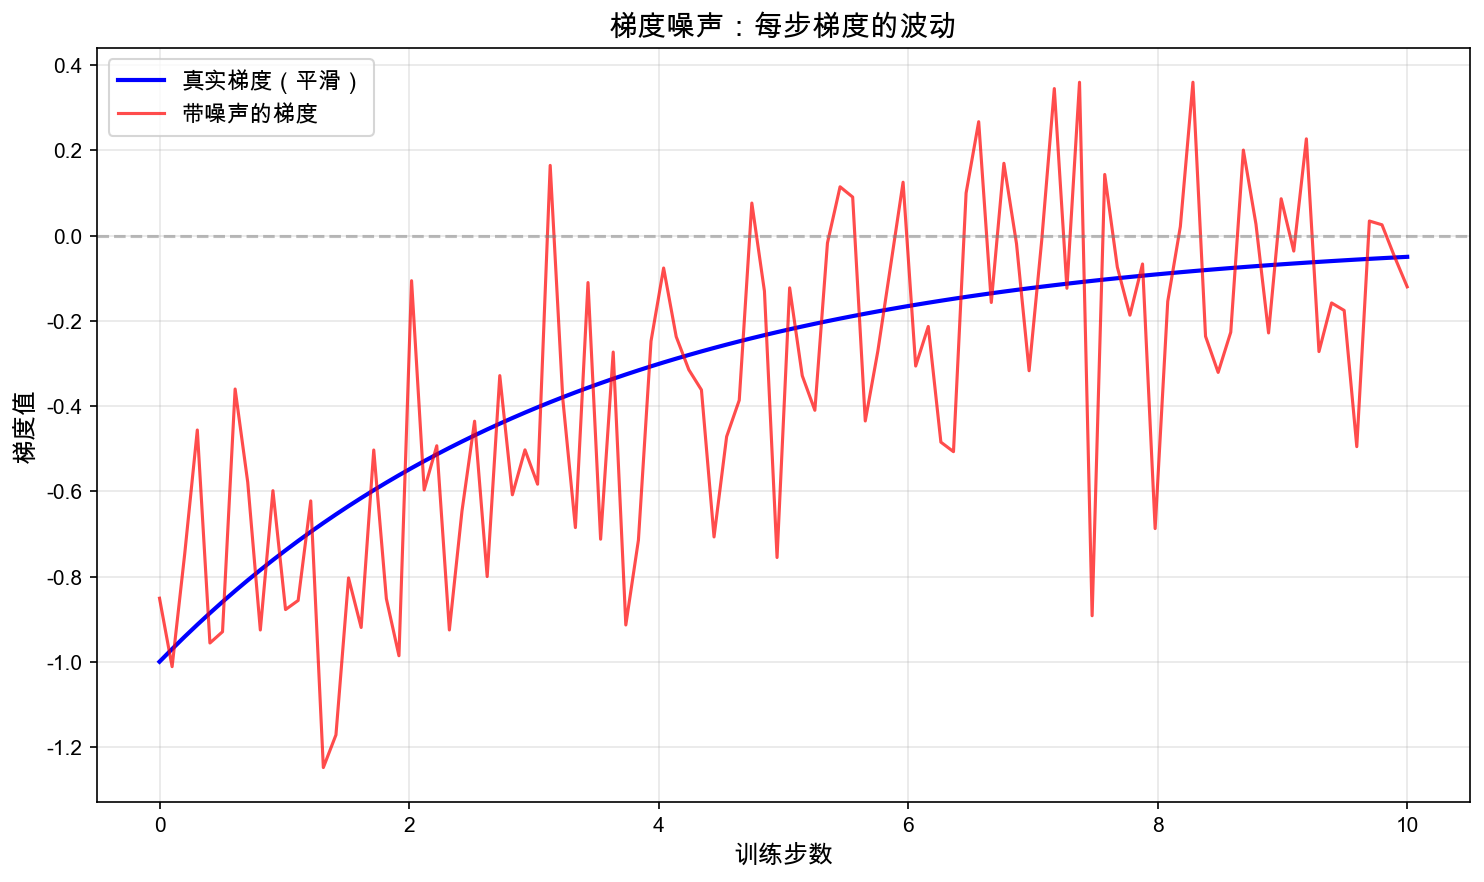
想象你在山上,想尽快下到谷底。SGD的策略是:每走一步,看看哪个方向最陡,就往那个方向走。
优点:
- 实现简单,内存占用小
- 泛化性能好(因为参数更新有噪声,有助于跳出局部最优)
- 对大模型训练的内存友好
缺点:
- 梯度有噪声,训练不稳定
- 学习率难以调优,不同参数需要不同的学习率
- 在鞍点和局部最优附近容易震荡
1.3 Mini-batch SGD
实际训练中,我们很少用全量数据计算梯度(太慢),通常使用mini-batch:
- 从训练集中随机抽取一批样本(如32、64、128个)
- 在这批样本上计算梯度
- 用这个梯度更新参数
gt=B1i=1∑B∇θL(xi,yi;θ)
其中 B 是batch size。Mini-batch SGD是SGD最常用的实现形式。
2. SGD + Momentum:添加一阶动量
2.1 问题:梯度噪声导致训练不稳定
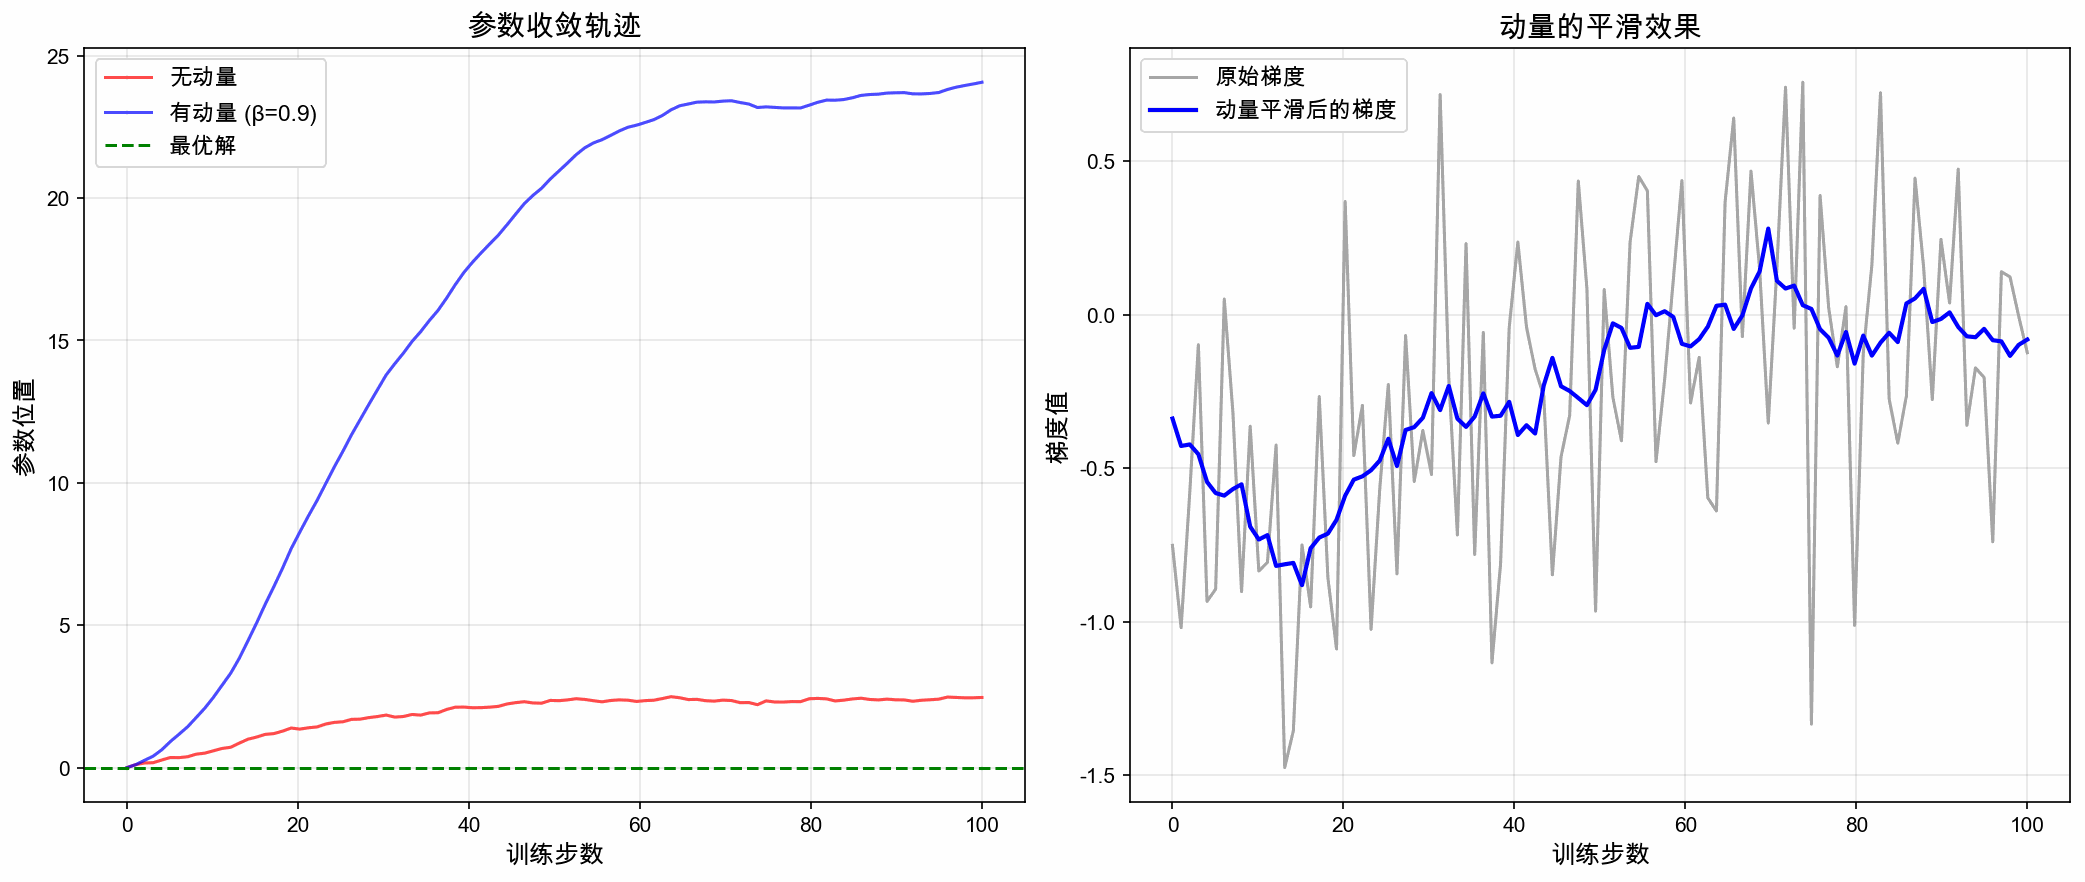
在实际训练中,每一步的梯度 gt 会因为mini-batch的随机性而波动。如果没有动量,参数更新会像醉汉走路一样忽左忽右。
2.2 解决方案:引入一阶动量
**动量(Momentum)**的思想是:不要只看当前一步的梯度,而是看历史梯度的累积方向。
一阶动量的定义:
mt=β⋅mt−1+gt
其中:
- mt 是一阶动量(梯度的指数移动平均)
- β 是衰减系数,通常设为0.9
- gt 是当前梯度
参数更新:
θt=θt−1−η⋅mt
在统一框架下的表示:
θt=θt−1−st+ϵη⋅mt
SGD+Momentum有了一阶动量 mt,但仍然没有二阶矩 st。
直观理解:把参数更新想象成一个滚动的球。球在下坡时会越来越快,即使路上有小石头(噪声梯度),球也会因为惯性继续向前。
代码实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
| class SGD_Momentum:
def __init__(self, params, lr=0.01, momentum=0.9):
self.params = params
self.lr = lr
self.momentum = momentum
self.m = [0] * len(params)
def step(self):
for i, param in enumerate(self.params):
self.m[i] = self.momentum * self.m[i] + param.grad
param.data -= self.lr * self.m[i]
|
优点:
- 平滑梯度,减少训练震荡
- 加速收敛,尤其是对于高曲率区域
- 是许多经典模型(ResNet、VGG等)的训练选择
缺点:
2.3 Nesterov 动量:看得更远
普通动量先计算梯度,再更新参数。但 Nesterov 动量更聪明:先预估下一步的位置,再在那个位置计算梯度。
更新公式:
θlookahead=θt−1+β⋅mt−1
mt=β⋅mt−1+g(θlookahead)
θt=θt−1−η⋅mt
直观理解:普通动量是"先看路再走",Nesterov是"先走一步再看路"。这样能更早发现前方的障碍,做出更准确的调整。
3. 自适应学习率优化器:添加二阶矩
3.1 问题:不同参数需要不同的学习率
在神经网络中,有些参数经常收到大的梯度,有些参数的梯度很小。如果我们对所有参数用相同的学习率:
- 梯度大的参数:可能更新太猛,震荡
- 梯度小的参数:可能更新太慢,学不动
3.2 AdaGrad:第一个自适应优化器
AdaGrad的思想是:对经常收到大梯度的参数降低学习率,对经常收到小梯度的参数提高学习率。
二阶矩的定义:
st=st−1+gt2
参数更新:
θt=θt−1−st+ϵη⋅gt
在统一框架下的表示:
θt=θt−1−st+ϵη⋅mt
AdaGrad有二阶矩 st,但没有一阶动量 mt。
其中 st 是历史梯度的平方和,ϵ 是防止除零的小常数。
直观理解:想象你在沙地上走路,每走一步都会留下脚印(梯度平方)。走过很多次的地方脚印深,走起来更吃力(学习率降低);没怎么走过的地方脚印浅,走起来轻松(学习率提高)。
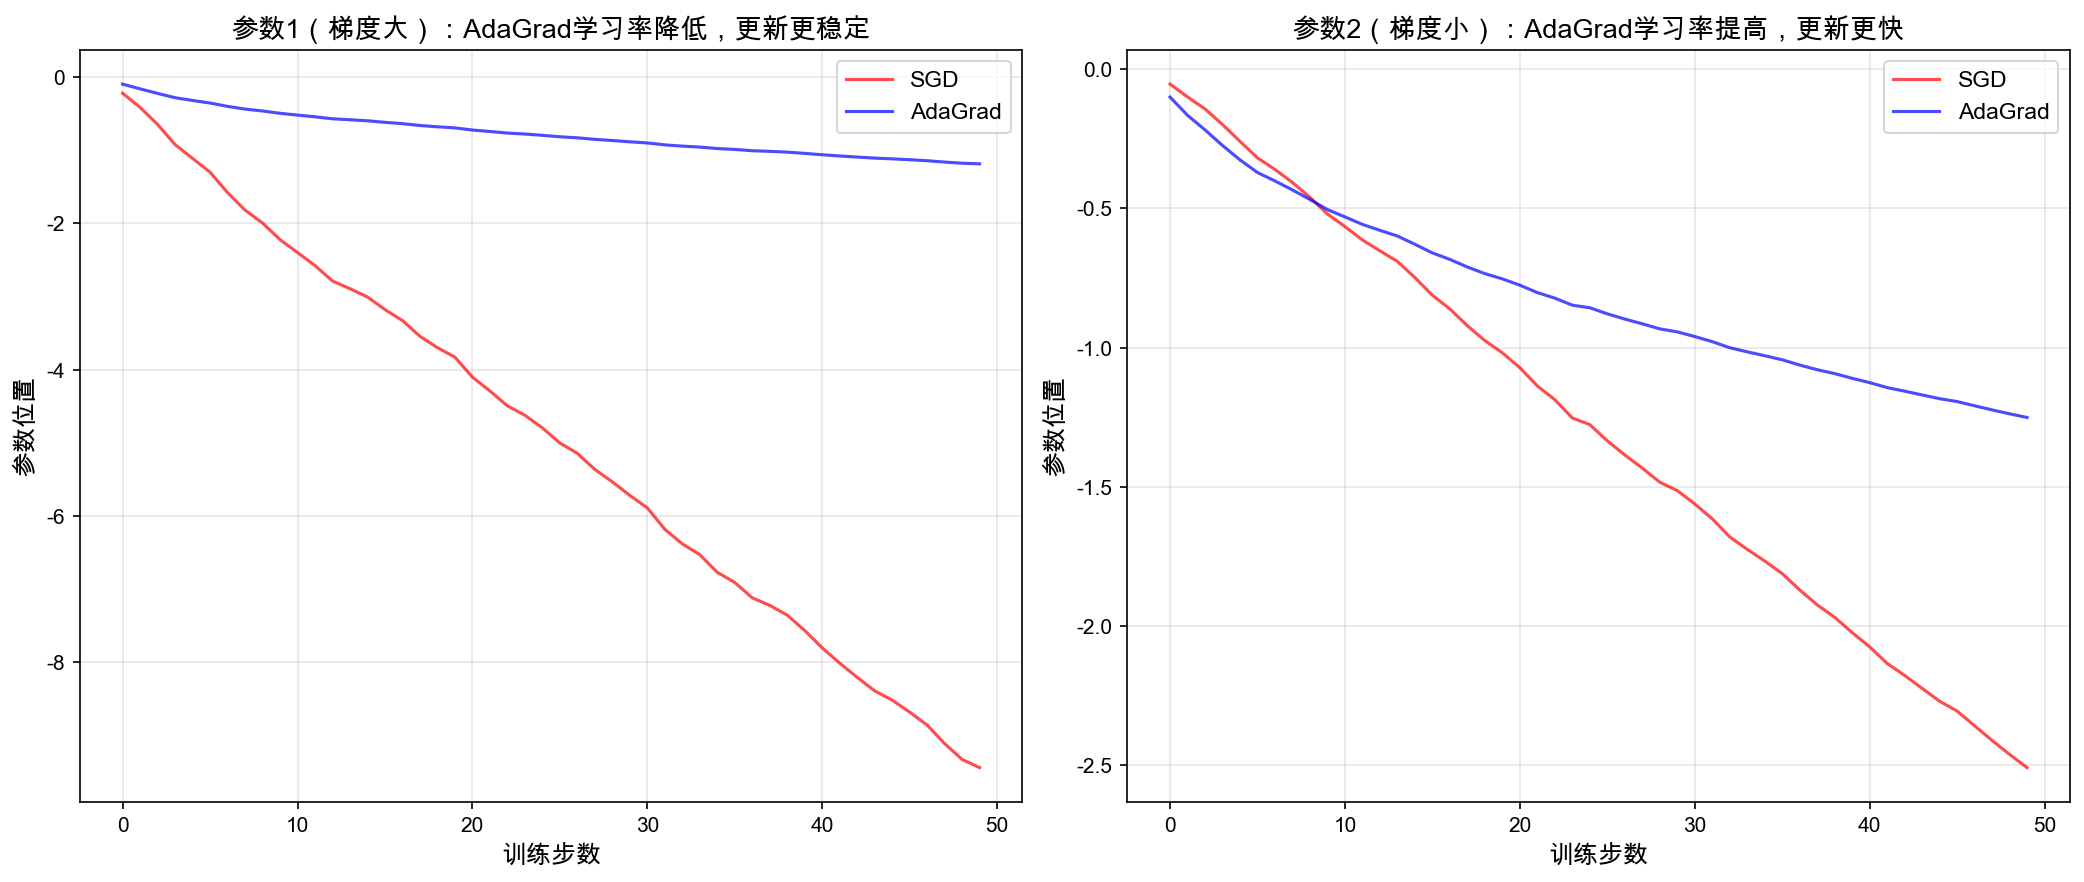
AdaGrad的问题:st 只增不减,导致学习率越来越小,最终趋近于0,训练提前"刹车"。
3.3 RMSProp:指数移动平均
RMSProp解决了AdaGrad学习率衰减过快的问题。它用指数移动平均代替累积和:
二阶矩的定义:
st=β⋅st−1+(1−β)⋅gt2
参数更新:
θt=θt−1−st+ϵη⋅gt
其中 β 通常设为0.999。
直观理解:AdaGrad记住所有历史,RMSProp只记住最近的信息。就像短期记忆vs长期记忆。
4. Adam:一阶动量 + 二阶矩的完美结合
现在,我们已经分别介绍了:
- 一阶动量 mt:解决梯度噪声问题(SGD+Momentum)
- 二阶矩 st:解决学习率自适应问题(RMSProp)
Adam把这两个组件完美地结合在一起:
4.1 一阶动量(解决噪声问题)
mt=β1⋅mt−1+(1−β1)⋅gt
其中 β1 通常设为0.9。
4.2 二阶矩(解决学习率问题)
st=β2⋅st−1+(1−β2)⋅gt2
其中 β2 通常设为0.999。
4.3 偏差修正
训练初期,mt 和 st 都是从0开始的,会被低估。需要进行偏差修正:
m^t=1−β1tmt
s^t=1−β2tst
4.4 参数更新
θt=θt−1−s^t+ϵη⋅m^t
在统一框架下的完整表示:
θt=θt−1−st+ϵη⋅mt
Adam同时具备一阶动量 mt 和二阶矩 st,是当前最流行的优化器。
代码实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| class Adam:
def __init__(self, params, lr=0.001, beta1=0.9, beta2=0.999, eps=1e-8):
self.params = params
self.lr = lr
self.beta1 = beta1
self.beta2 = beta2
self.eps = eps
self.m = [0] * len(params)
self.s = [0] * len(params)
self.t = 0
def step(self):
self.t += 1
for i, param in enumerate(self.params):
g = param.grad
self.m[i] = self.beta1 * self.m[i] + (1 - self.beta1) * g
self.s[i] = self.beta2 * self.s[i] + (1 - self.beta2) * g * g
m_hat = self.m[i] / (1 - self.beta1 ** self.t)
s_hat = self.s[i] / (1 - self.beta2 ** self.t)
param.data -= self.lr * m_hat / (np.sqrt(s_hat) + self.eps)
|
默认超参数:
- 学习率 η:1e-3(小模型)或 1e-4(大模型)
- β1:0.9
- β2:0.999
- ϵ:1e-8
优点:
- 收敛快,对学习率不敏感
- 内存占用适中
- 适合稀疏梯度(如NLP中的词嵌入)
缺点:
- 内存占用是SGD的3倍(需存储m和s)
- 在某些任务上泛化不如SGD
- 大模型训练中需要配合特定的学习率调度
5. AdamW:解耦权重衰减
5.1 问题:权重衰减的"欺骗"
Adam中使用L2正则化(权重衰减)时,存在一个问题:权重衰减会"欺骗"自适应学习率。
原因:权重衰减会改变梯度的大小,但自适应学习率是根据梯度大小来调整学习率的。这导致权重衰减的效果被学习率的调整所抵消。
5.2 解决方案:解耦权重衰减
AdamW将权重衰减从梯度计算中解耦出来,直接在参数更新后应用:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| class AdamW:
def __init__(self, params, lr=0.001, beta1=0.9, beta2=0.999, eps=1e-8, weight_decay=0.01):
self.params = params
self.lr = lr
self.beta1 = beta1
self.beta2 = beta2
self.eps = eps
self.weight_decay = weight_decay
self.m = [0] * len(params)
self.s = [0] * len(params)
self.t = 0
def step(self):
self.t += 1
for i, param in enumerate(self.params):
g = param.grad
self.m[i] = self.beta1 * self.m[i] + (1 - self.beta1) * g
self.s[i] = self.beta2 * self.s[i] + (1 - self.beta2) * g * g
m_hat = self.m[i] / (1 - self.beta1 ** self.t)
s_hat = self.s[i] / (1 - self.beta2 ** self.t)
param.data -= self.lr * m_hat / (np.sqrt(s_hat) + self.eps)
param.data -= self.lr * self.weight_decay * param.data
|
效果:AdamW在大模型训练中已成为标配,收敛更快,泛化更好。
6. 2024-2025年最新优化器
6.1 Muon:专为大模型设计的优化器
**Muon(Model Update Optimizer)**是2023年Google提出的一种专门针对大模型训练的优化器。
核心思想:传统优化器(如Adam)基于梯度进行更新,但梯度的方差很大。Muon提出直接在模型更新(而非梯度)上进行优化。
关键创新:
- 模型更新空间的优化:在参数空间的更新方向上应用动量,而非梯度空间
- 低秩更新:利用模型更新的低秩结构,大幅减少内存占用
- 自适应缩放:根据层的类型(注意力层、FFN层)应用不同的学习率
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
|
class Muon:
def __init__(self, params, lr=0.005, momentum=0.95, update_decay=0.9):
self.params = params
self.lr = lr
self.momentum = momentum
self.update_decay = update_decay
self.m = [0] * len(params)
self.u = [0] * len(params)
def step(self):
for i, param in enumerate(self.params):
g = param.grad
update = -self.lr * g
self.m[i] = self.momentum * self.m[i] + (1 - self.momentum) * update
self.u[i] = self.update_decay * self.u[i] + update
param.data += update
|
优势:
- 内存占用比Adam低约30%
- 在LLaMA、Mistral等模型上效果优异
- 收敛更快,loss更低
6.2 Adafactor:内存高效的自适应优化器
Adafactor是Google为大模型训练设计的优化器,核心目标是减少内存占用。
核心思想:
- 低秩分解:不存储完整的二阶矩矩阵,而是将其分解为两个低秩矩阵
- 序列轴特殊处理:对于注意力层,沿序列维度使用一维的二阶矩
- 相对学习率:学习率相对于参数值,而非固定值
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
|
class Adafactor:
def __init__(self, params, lr=None, eps1=1e-30, eps2=0.001, clip_threshold=1.0):
self.params = params
self.eps1 = eps1
self.eps2 = eps2
self.clip_threshold = clip_threshold
self.v_row = [None] * len(params)
self.v_col = [None] * len(params)
self.v_scale = [None] * len(params)
def step(self):
for i, param in enumerate(self.params):
g = param.grad
shape = g.shape
if len(shape) >= 2:
v_row = (g ** 2).mean(dim=-1, keepdim=True)
v_col = (g ** 2).mean(dim=-2, keepdim=True)
v = v_row * v_col
else:
v = (g ** 2).mean() * np.ones(shape)
decay_rate = 0.8
if self.v_scale[i] is None:
self.v_scale[i] = v
else:
self.v_scale[i] = decay_rate * self.v_scale[i] + (1 - decay_rate) * v
std = np.sqrt(self.v_scale[i] + self.eps1)
g_scaled = g / (std + self.eps1)
g_scaled = np.clip(g_scaled, -self.clip_threshold, self.clip_threshold)
if lr is None:
lr = self.eps2 * np.sqrt(shape[-1])
param.data -= lr * g_scaled
|
优势:
- 内存占用比Adam低约40%
- 在Gemma、T5等模型上效果优异
- 特别适合超大模型训练
6.3 Muon + Adam混合策略
最新的实践表明,混合使用不同优化器可以获得更好的效果。例如:
- 注意力层:使用Muon(因为注意力层的更新有明显的低秩结构)
- FFN层:使用AdamW(因为FFN层的梯度更稀疏)
这种策略在LLaMA 3.1、DeepSeek-V3等模型中被采用。
1
2
3
4
5
6
7
8
9
|
class HybridOptimizer:
def __init__(self, model, lr=0.0005):
self.muon_optimizer = Muon(get_attention_params(model), lr=lr)
self.adam_optimizer = AdamW(get_ffn_params(model), lr=lr)
def step(self):
self.muon_optimizer.step()
self.adam_optimizer.step()
|
6.4 最新优化器对比
| 优化器 |
提出时间 |
核心特点 |
适用场景 |
内存占用 |
| AdamW |
2017-2019 |
自适应+解耦权重衰减 |
通用 |
3×SGD |
| Adafactor |
2018 |
低秩二阶矩 |
超大模型 |
2.4×SGD |
| Muon |
2023 |
模型更新空间优化 |
LLM预训练 |
2.7×SGD |
| Muon+Adam混合 |
2024 |
分层优化 |
最新LLM |
2.7×SGD |
7. 统一框架总结
现在,让我们用一个完整的图来总结所有优化算法在统一框架下的关系:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
| ┌─────────────────────────────────────────────────────────────────┐
│ 优化算法统一框架 │
├─────────────────────────────────────────────────────────────────┤
│ │
│ 统一更新公式:θ_t = θ_{t-1} - η·m_t / (√s_t + ε) │
│ │
│ ┌─────────────────────────────────────────────────────────┐ │
│ │ m_t (一阶动量) │ │
│ │ ┌─────────────────────────────────────────────────┐ │ │
│ │ │ 解决问题:梯度噪声大,方向不稳定 │ │ │
│ │ │ │ │ │
│ │ │ SGD → 无动量 │ │ │
│ │ │ Momentum → m_t = β·m_{t-1} + g_t │ │ │
│ │ │ Nesterov → 在预判位置计算梯度 │ │ │
│ │ │ Adam → m_t = β₁·m_{t-1} + (1-β₁)·g_t │ │ │
│ │ └─────────────────────────────────────────────────┘ │ │
│ └─────────────────────────────────────────────────────────┘ │
│ │
│ ┌─────────────────────────────────────────────────────────┐ │
│ │ s_t (二阶矩/自适应学习率) │ │
│ │ ┌─────────────────────────────────────────────────┐ │ │
│ │ │ 解决问题:不同参数需要不同的学习率 │ │ │
│ │ │ │ │ │
│ │ │ SGD → 无自适应 │ │ │
│ │ │ AdaGrad → s_t = s_{t-1} + g_t² │ │ │
│ │ │ RMSProp → s_t = β·s_{t-1} + (1-β)·g_t² │ │ │
│ │ │ Adam → s_t = β₂·s_{t-1} + (1-β₂)·g_t² │ │ │
│ │ │ Adafactor → 低秩分解的s_t │ │ │
│ │ └─────────────────────────────────────────────────┘ │ │
│ └─────────────────────────────────────────────────────────┘ │
│ │
│ 算法组合: │
│ ┌──────────┬──────────┬──────────────────────────────────┐ │
│ │ 一阶动量 │ 二阶矩 │ 算法 │ │
│ ├──────────┼──────────┼──────────────────────────────────┤ │
│ │ ❌ │ ❌ │ SGD │ │
│ │ ✅ │ ❌ │ SGD+Momentum, Nesterov │ │
│ │ ❌ │ ✅ │ AdaGrad, RMSProp, Adafactor │ │
│ │ ✅ │ ✅ │ Adam, AdamW │ │
│ └──────────┴──────────┴──────────────────────────────────┘ │
│ │
└─────────────────────────────────────────────────────────────────┘
|
各算法的组件对比表:
| 算法 |
一阶动量 mt |
二阶矩 st |
权重衰减 |
特点 |
| SGD |
❌ |
❌ |
L2 |
最简单,泛化好 |
| SGD+Momentum |
✅ βmt−1+gt |
❌ |
L2 |
平滑梯度,加速收敛 |
| Nesterov |
✅ 预估位置计算梯度 |
❌ |
L2 |
更准确的动量 |
| AdaGrad |
❌ |
✅ st−1+gt2 |
L2 |
自适应,但学习率衰减快 |
| RMSProp |
❌ |
✅ βst−1+(1−β)gt2 |
L2 |
解决学习率衰减问题 |
| Adam |
✅ β1mt−1+(1−β1)gt |
✅ β2st−1+(1−β2)gt2 |
L2 |
一阶矩+二阶矩 |
| AdamW |
✅ |
✅ |
解耦 |
解决权重衰减问题 |
| Adafactor |
✅ |
✅ 低秩 |
解耦 |
内存高效 |
| Muon |
✅ 更新空间 |
❌ |
解耦 |
专为LLM设计 |
8. 学习率调度策略
8.1 Warmup + Cosine Decay
大模型训练的标准配置:
1
2
3
4
5
6
7
8
9
10
11
| import math
def get_lr(step, warmup_steps, total_steps, base_lr, min_lr):
if step < warmup_steps:
return base_lr * step / warmup_steps
else:
decay_ratio = (step - warmup_steps) / (total_steps - warmup_steps)
coeff = 0.5 * (1 + math.cos(math.pi * decay_ratio))
return min_lr + coeff * (base_lr - min_lr)
|
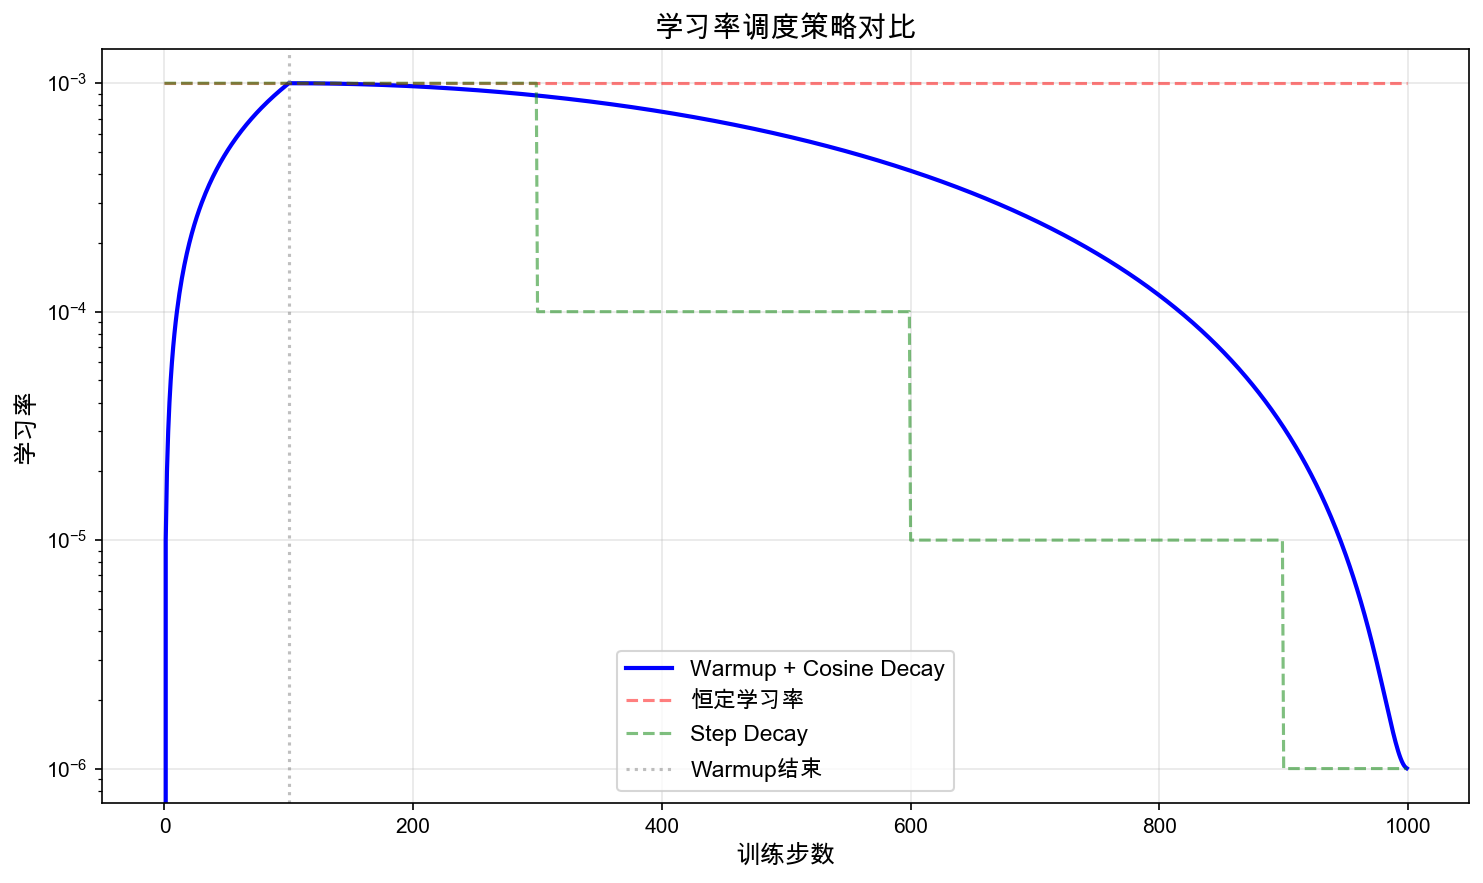
为什么需要warmup? 训练初期,参数随机初始化,梯度噪声大。如果一开始用大学习率,参数更新会很不稳定。warmup让学习率从小值逐渐增大,等训练稳定后再加速学习。
8.2 常见调度策略对比
| 策略 |
特点 |
适用场景 |
| 恒定 |
简单,无调度 |
小模型,调试阶段 |
| Step Decay |
按固定步数衰减 |
传统CNN训练 |
| Cosine Decay |
平滑衰减到最小值 |
大模型预训练 |
| Warmup + Cosine |
先warmup再cosine |
大模型标准配置 |
| Linear Decay |
线性衰减到0 |
BERT等模型 |
9. 实践建议
9.1 如何选择优化算法?
| 场景 |
推荐算法 |
理由 |
| 通用默认选择 |
AdamW |
平衡了收敛速度和泛化性能 |
| 大模型预训练(2024+) |
AdamW + warmup + cosine |
工业界标准配置 |
| 追求极致效率 |
Muon / Adafactor |
内存占用低,收敛快 |
| 最新LLM训练 |
Muon+Adam混合 |
分层优化,效果最佳 |
| 需要更好泛化 |
SGD+Momentum |
简单,泛化gap小 |
| 推荐系统 |
稀疏优化器(如FTRL) |
适合稀疏特征 |
9.2 超参数设置建议
Adam/AdamW(大模型训练):
- 学习率 η:1e-4 ~ 5e-5
- β1:0.9
- β2:0.95 ~ 0.999(大模型常用0.95)
- ϵ:1e-8
- 权重衰减:0.01 ~ 0.1
- Warmup步数:1000 ~ 5000
SGD+Momentum:
- 学习率 η:0.01 ~ 0.1
- 动量 β:0.9
- 学习率调度:余弦退火
Muon:
- 学习率 η:0.005 ~ 0.01
- 动量:0.95
- 更新衰减:0.9
10. 可视化对比
让我们用一个简单的二维优化问题来可视化不同优化算法的行为。
目标函数:f(x,y)=x2+10y2(一个椭圆形的碗)
起始点:(2.5,1.5)
最优解:(0,0)
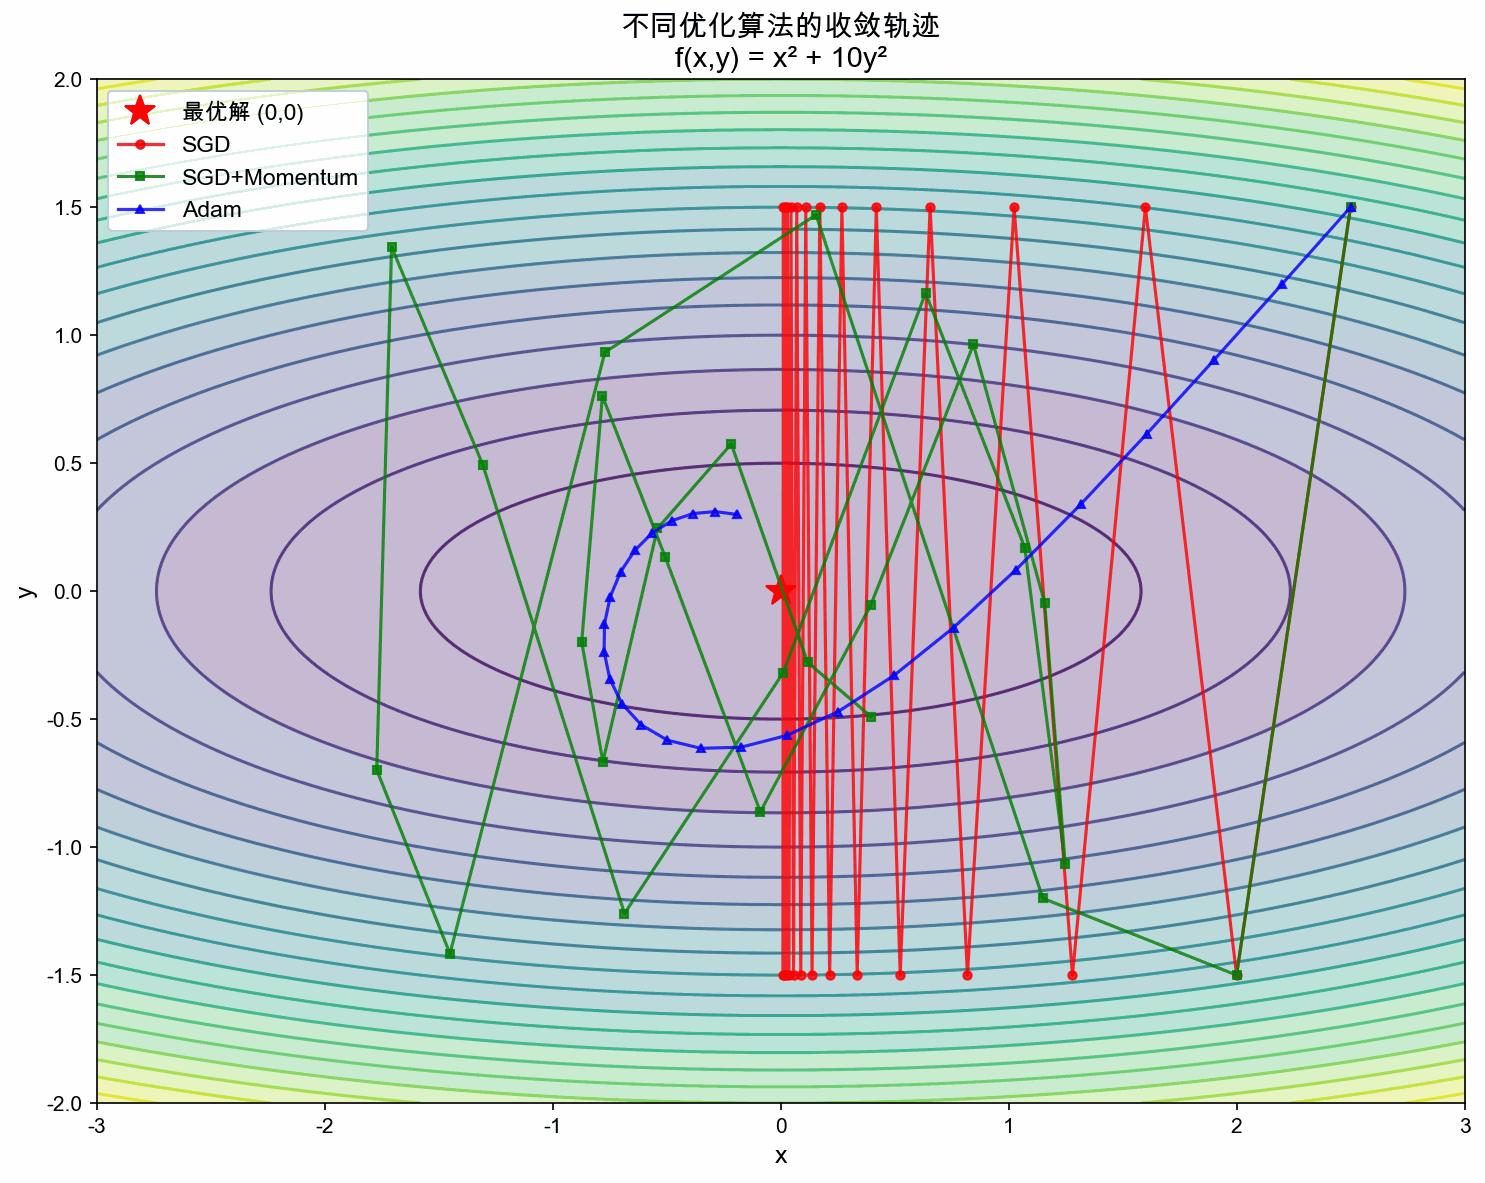
从图中可以看到:
- SGD:路径曲折,震荡明显
- SGD+Momentum:路径更直,但仍然有震荡
- Adam:快速收敛到最优解,路径平滑
11. 总结
通过本文,我们用一个统一的框架理解了所有优化算法:
核心框架
θt=θt−1−st+ϵη⋅mt
- mt(一阶动量):解决梯度噪声问题 → SGD+Momentum, Nesterov, Adam
- st(二阶矩):解决学习率自适应问题 → AdaGrad, RMSProp, Adam, Adafactor
- 两者结合:Adam = 一阶动量 + 二阶矩
算法演进路线
1
2
3
4
5
6
7
8
9
| SGD(无动量,无自适应)
↓ 添加一阶动量
SGD+Momentum → Nesterov
↓ 添加二阶矩
Adam
↓ 解耦权重衰减
AdamW
↓ 专为大模型优化
Muon / Adafactor / 混合策略
|
实践建议
- 2024年前:AdamW + warmup + cosine decay
- 2024年后:考虑Muon+Adam混合策略
- 始终使用:学习率调度(warmup + cosine decay)
理解了这个统一框架,你就能更好地理解各种优化算法的设计思路,以及如何根据具体场景选择合适的优化器。
参考资料
