
假设我们要训练一个模型玩走迷宫:从入口出发,绕过墙壁,最后拿到宝箱。按照监督学习的思路,我们应该准备一批"输入-输出"数据:输入是当前位置,输出是正确的动作。但问题马上来了——谁来提供这个"正确的动作"? 在迷宫的第一个岔路口,往左还是往右?只有走到终点才知道。更麻烦的是,模型往左走之后,它接下来看到的所有画面都变了,它自己生成了自己的训练数据。
这就是强化学习(Reinforcement Learning, RL)要处理的问题:没有标准答案,只有事后的好坏评价;而且你的每一个决策都会改变你之后面对的世界。 这篇文章会讲清三件事:
- 强化学习和监督学习/半监督学习到底差在哪
- 描述这类问题的数学语言:马尔可夫决策过程(MDP)与贝尔曼方程
- 解决这类问题的三条技术路线,也就是后面三篇文章的地图
强化学习是什么
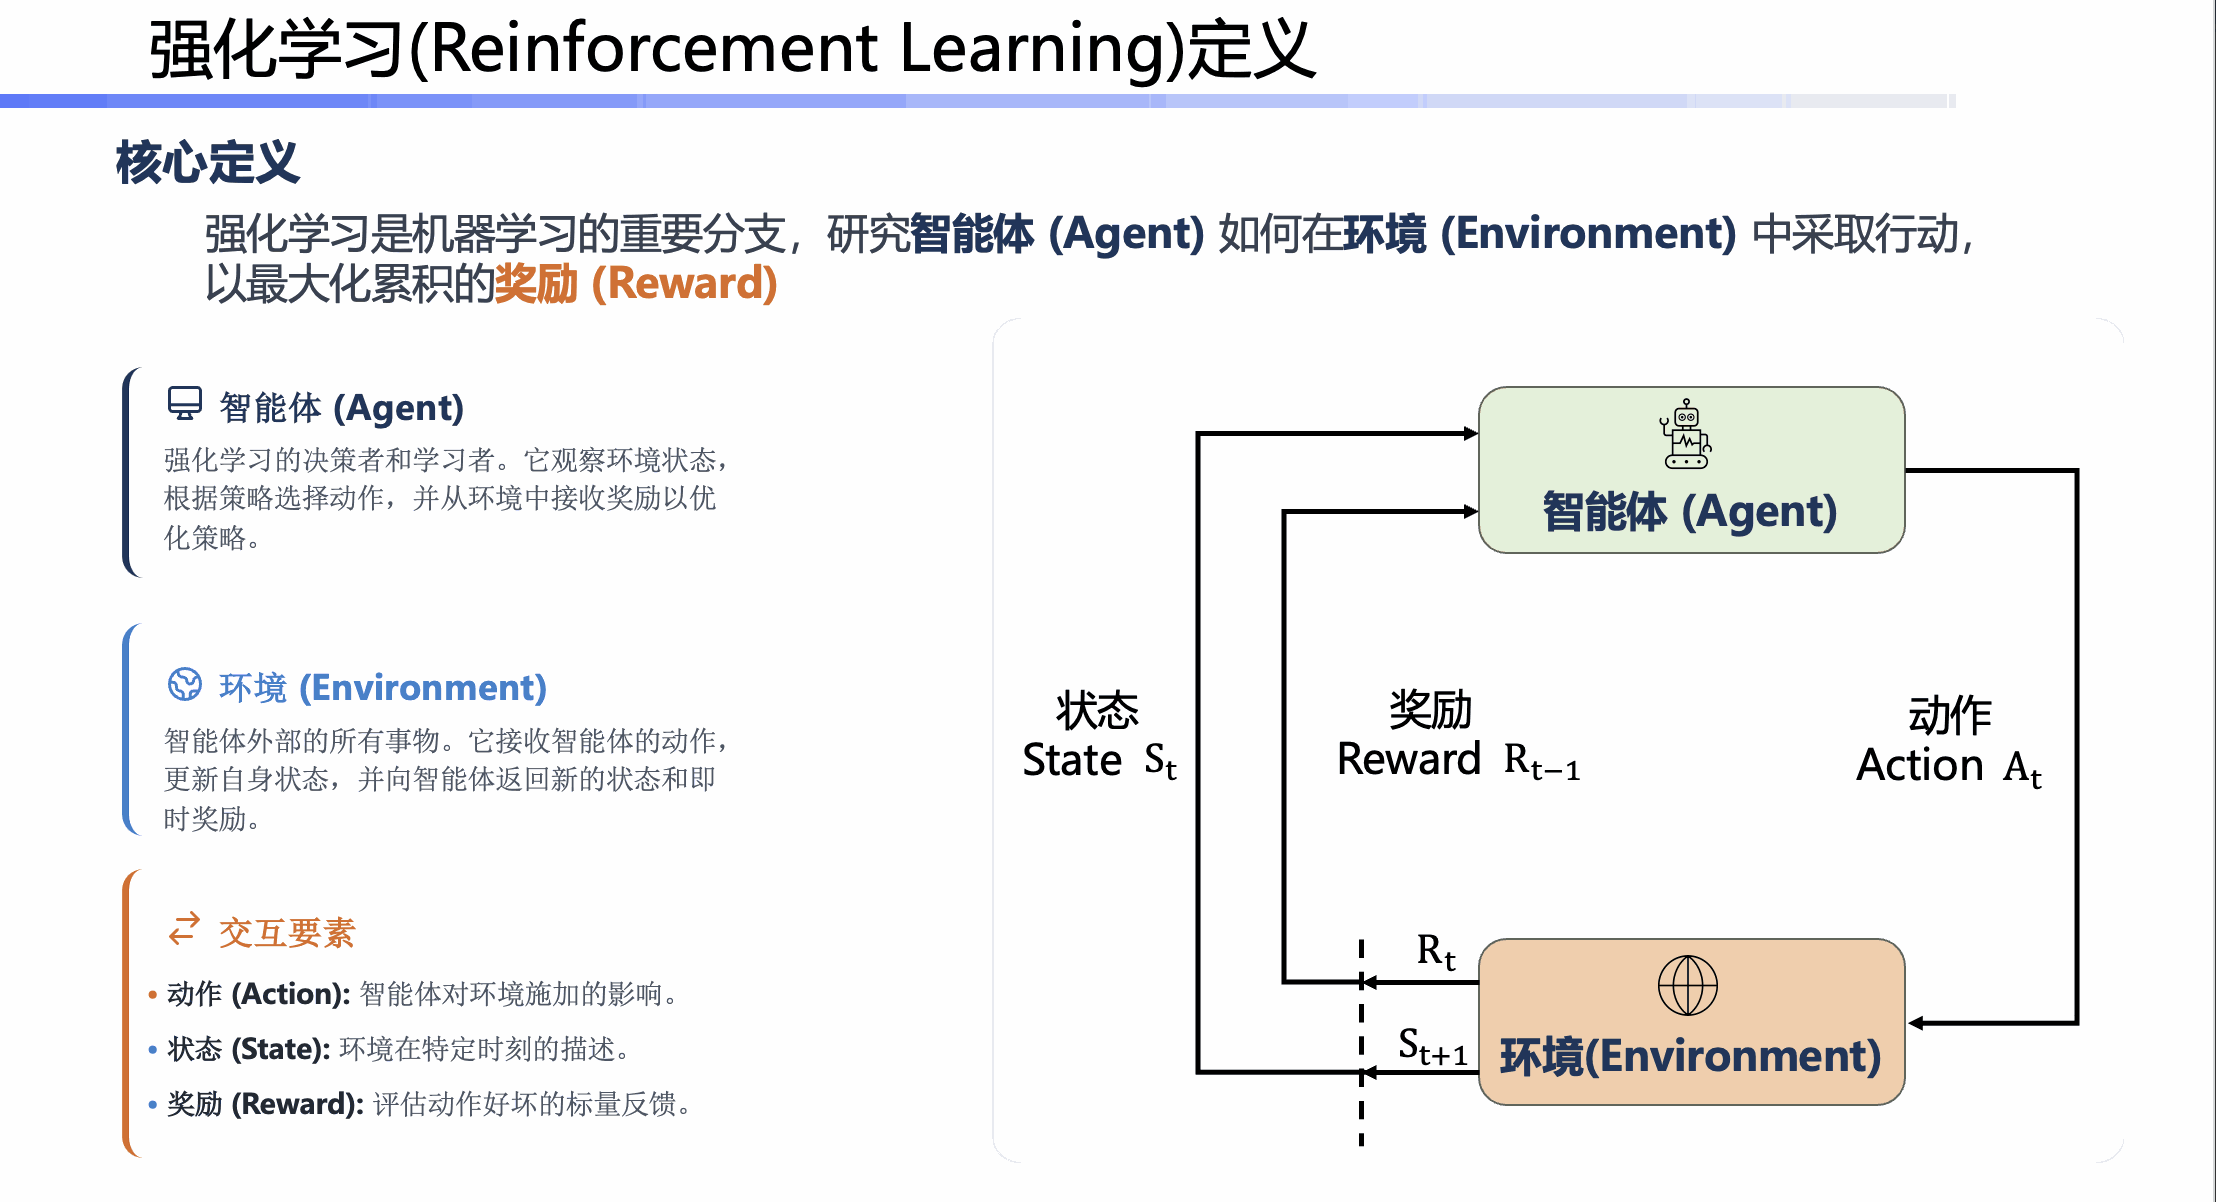 强化学习的世界里只有两个角色:智能体(agent) 和 环境(environment)。它们之间不断循环交互:
在 时刻,智能体观察到状态 ,选择一个动作 ,环境返回一个标量奖励 和新的状态 。
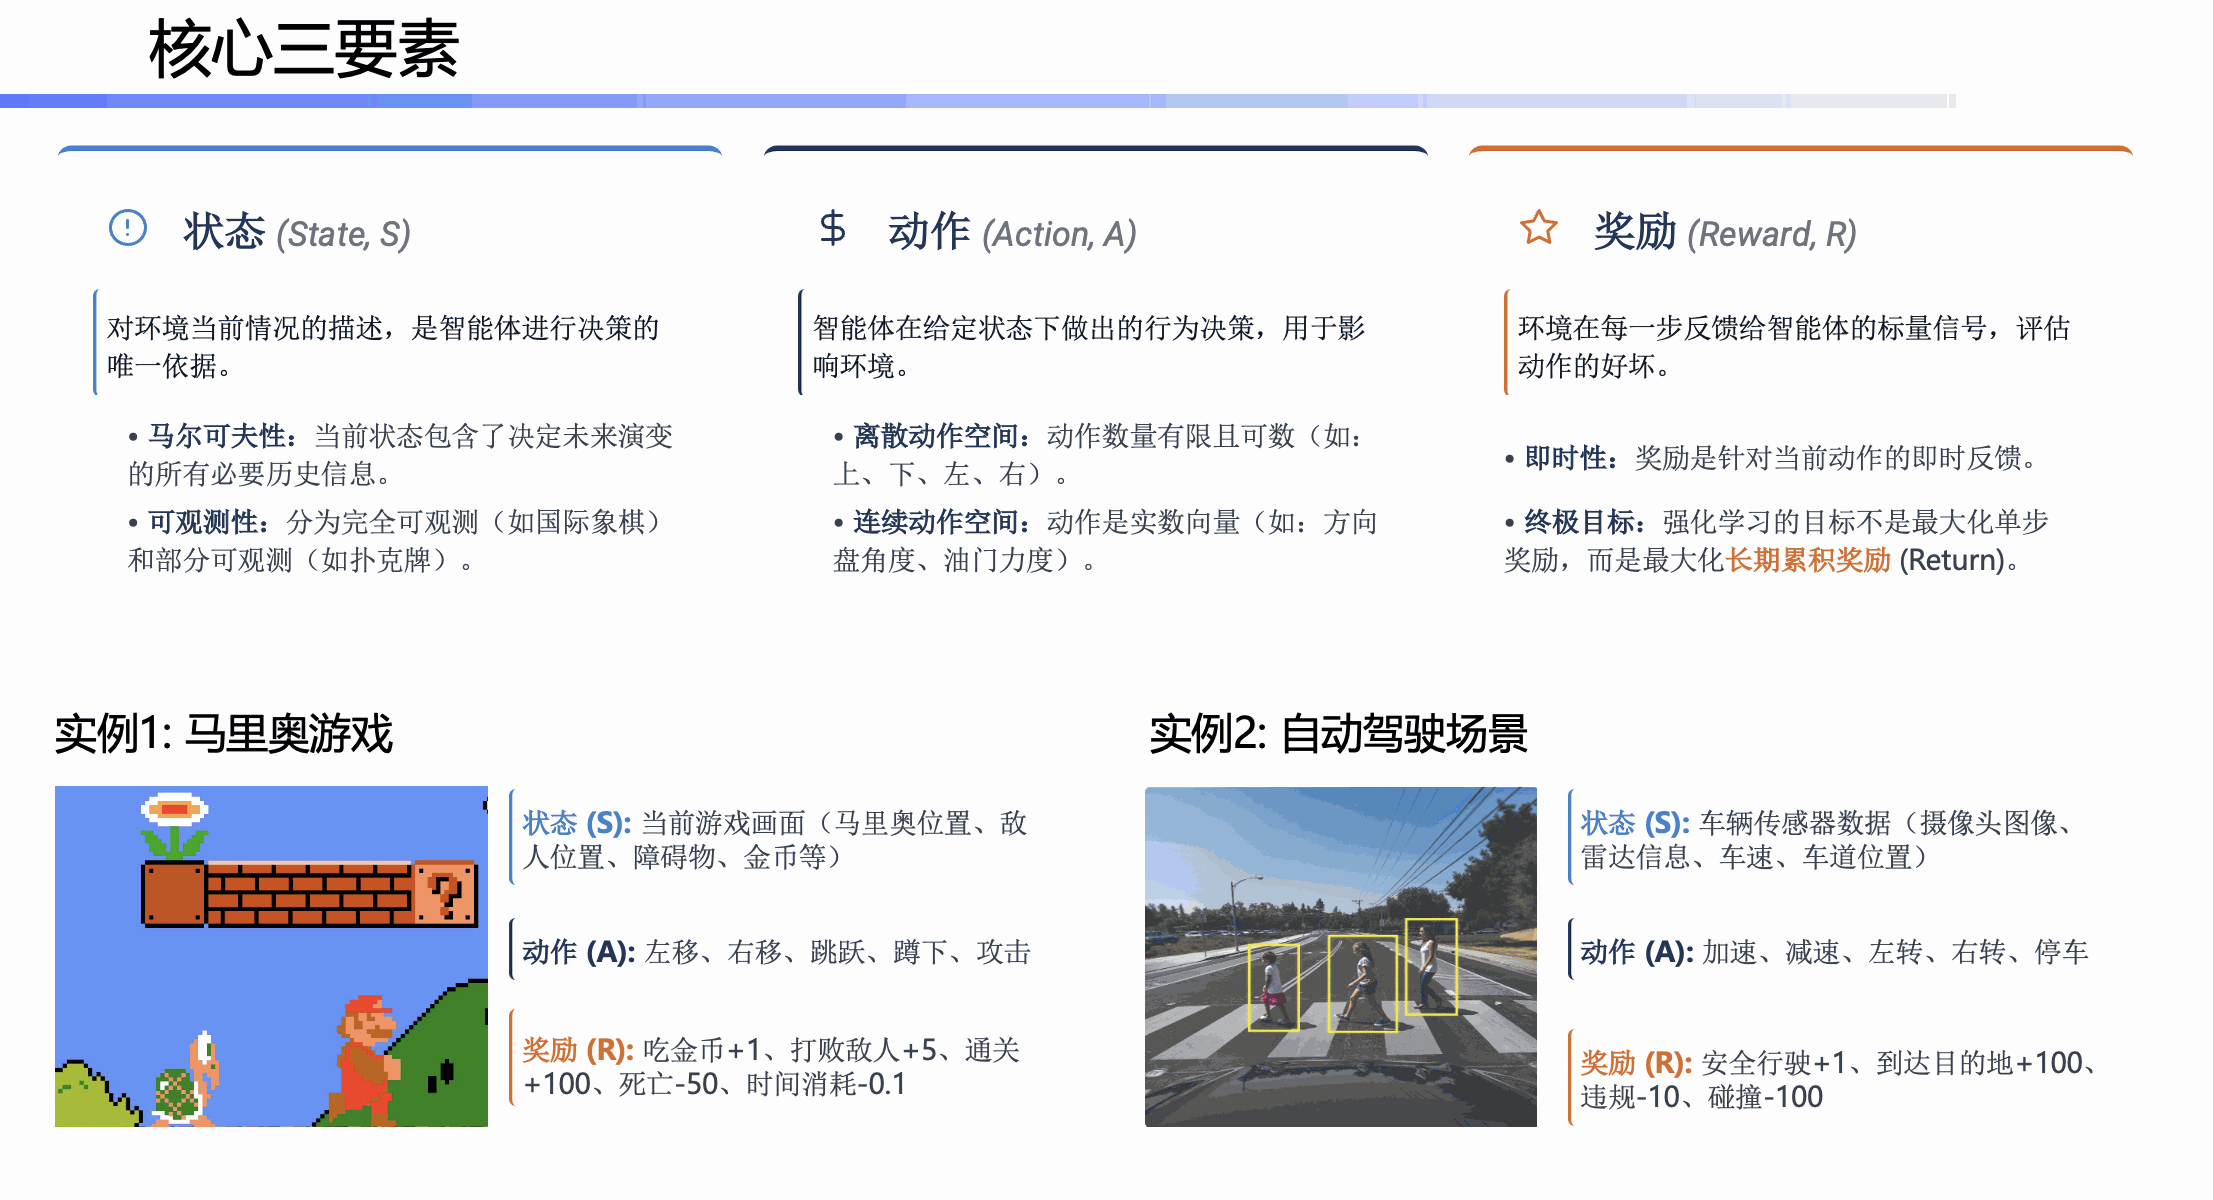
状态 是对环境当前情况的描述,是智能体进行决策的唯一依据。 是智能体在给定状态下做出的行为决策,用于影响环境。奖励 是环境在每一步反馈给智能体的标量信号,评估动作的好坏。在强化学习中,智能体不断与环境交互,产生一系列的状态、动作和奖励。基于这些序列,智能体就能学习到如何选择最佳动作,以获得最大累计奖励。这个设定虽然简单,但涵盖的范围非常广:
| 场景 | 状态 | 动作 | 奖励 |
|---|---|---|---|
| 走迷宫 | 当前坐标 | 上下左右 | 到达终点 +1 |
| Atari 游戏 | 最近几帧画面 | 摇杆按键 | 游戏分数变化 |
| 围棋 | 棋盘局面 | 落子位置 | 胜 +1 / 负 -1 |
| 机械臂抓取 | 关节角度、视觉 | 关节力矩 | 抓取成功 +1,能耗 -λ |
| LLM 的 RLHF | 已生成的 token 序列 | 下一个 token | 奖励模型给的打分 |
从这张表能看出强化学习最鲜明的三个特征:试错(trial-and-error)、延迟奖励(delayed reward)、序列决策。围棋下了 200 手才知道输赢,但真正的胜负关键可能在第 37 手——把最终结果分摊到每一步动作上,这个问题叫 信用分配(credit assignment),是强化学习最核心的困难。
与监督学习的本质区别
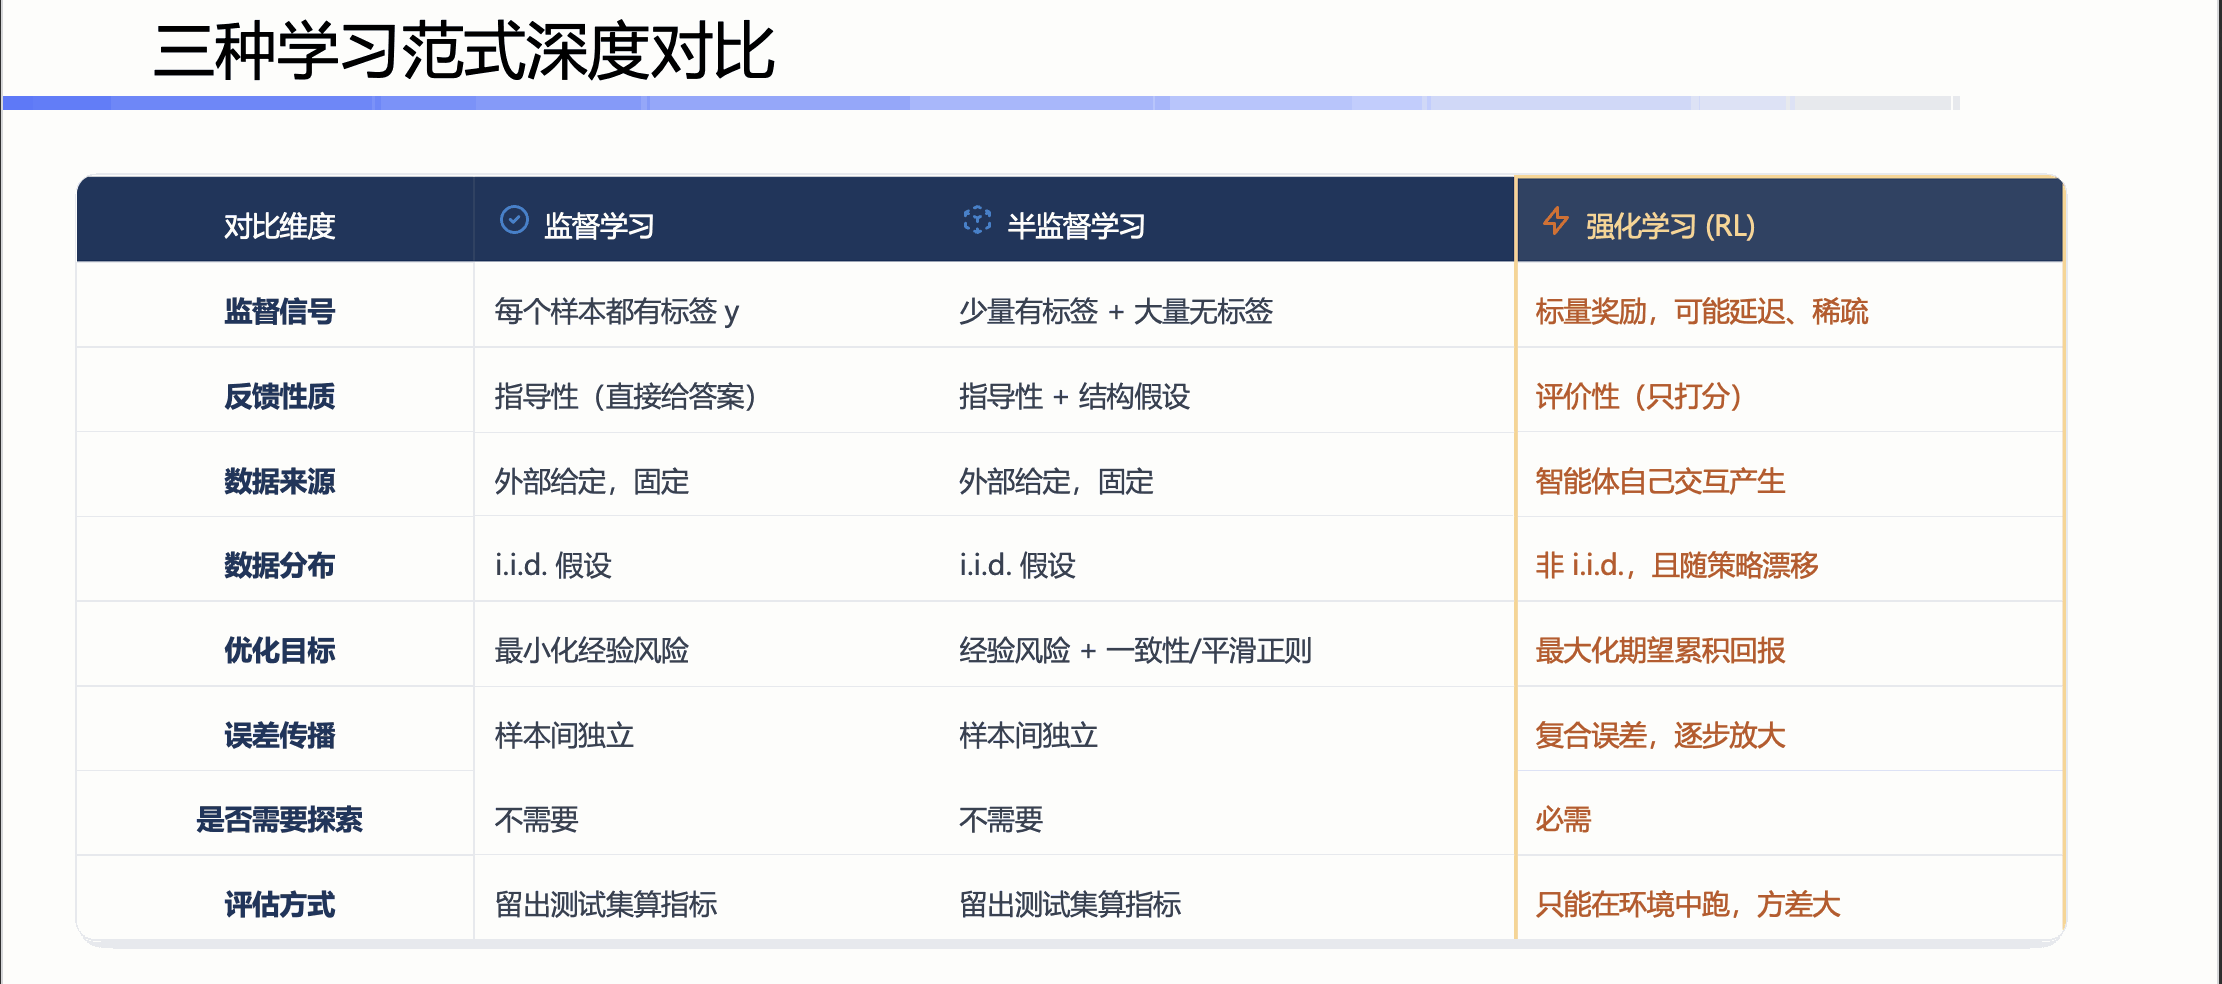
很多人第一次接触强化学习时会想:"能不能把它转化成监督学习?"值得认真回答这个问题,因为想清楚了,后面所有算法设计的动机都会变得自然。
反馈性质:指导性 vs 评价性
监督学习的反馈是指导性的(instructive):给定输入 ,标签 直接告诉你正确答案是什么。误差 不仅告诉你"错了",还告诉你"应该是多少"。
强化学习的反馈是评价性的(evaluative):奖励只告诉你"刚才那个动作有多好",不告诉你"最好的动作是什么"。你走了一条路得到 3 分,但你永远不知道另一条路是不是能得 10 分——除非你亲自去试。这就是探索(exploration) 存在的根本原因。
数据分布:固定 vs 随策略变化
监督学习假设数据独立同分布(i.i.d.),且训练集在训练过程中是固定的。强化学习的数据由智能体自己采集,因此:
- 数据不是 i.i.d.:同一条轨迹里相邻的状态高度相关(连续两帧画面几乎一样)
- 数据分布 依赖于当前策略 :策略一更新,看到的状态分布就变了
这是一个"追着自己尾巴跑"的优化问题。它带来的直接后果是:监督学习里那些依赖 i.i.d. 假设的结论(比如 SGD 的收敛性分析)都不能直接搬过来。第二篇讲 DQN 的经验回放(experience replay) 时会看到,它本质上就是在人为地把非 i.i.d. 的数据"洗"成接近 i.i.d.。
误差传播:独立 vs 累积
监督学习中每个样本的预测是独立的,一个样本预测错了不会影响下一个样本。强化学习中,一步决策错了会把你带到一个陌生的状态,在陌生状态上你的策略更容易出错,于是越错越远——这叫 复合误差(compounding error)。如果单步错误率是 , 步之后的总代价在最坏情况下可以放大到 量级,而不是 。
与半监督学习的异同
两者都在"监督信号稀缺"的情况下工作,这是相似之处。但解决思路完全不同:
- 半监督学习的假设是"标签缺了,但数据分布本身含有信息"。它靠聚类假设、流形假设、一致性正则(比如对同一张图做两次增强,要求输出一致)把无标签数据用起来。数据集始终是给定的、静态的。
- 强化学习的假设是"没人能给标签,但环境能给评价"。它靠自己去交互,把稀疏的评价通过贝尔曼方程沿时间反向传播,从而给每一步动作都算出一个"隐式标签"(也就是价值函数)。数据集是交互出来的、动态的。
为什么不能硬把 RL 写成监督学习
有人会说:把最终得分当标签,对整条轨迹的所有动作做加权回归,不就变成监督学习了?这确实是 REINFORCE 的雏形(第三篇会讲)。但它面临两个绕不开的困难:
- 信用分配:整条轨迹共享一个分数,无法区分是哪几步动作真正起了作用,梯度方差巨大
- 正标签只覆盖已探索的行为:模型只会强化它已经做过的事,永远发现不了没试过的更优解
强化学习的全部技术积累,基本都是在和这两个问题作斗争。
数学框架:马尔可夫决策过程
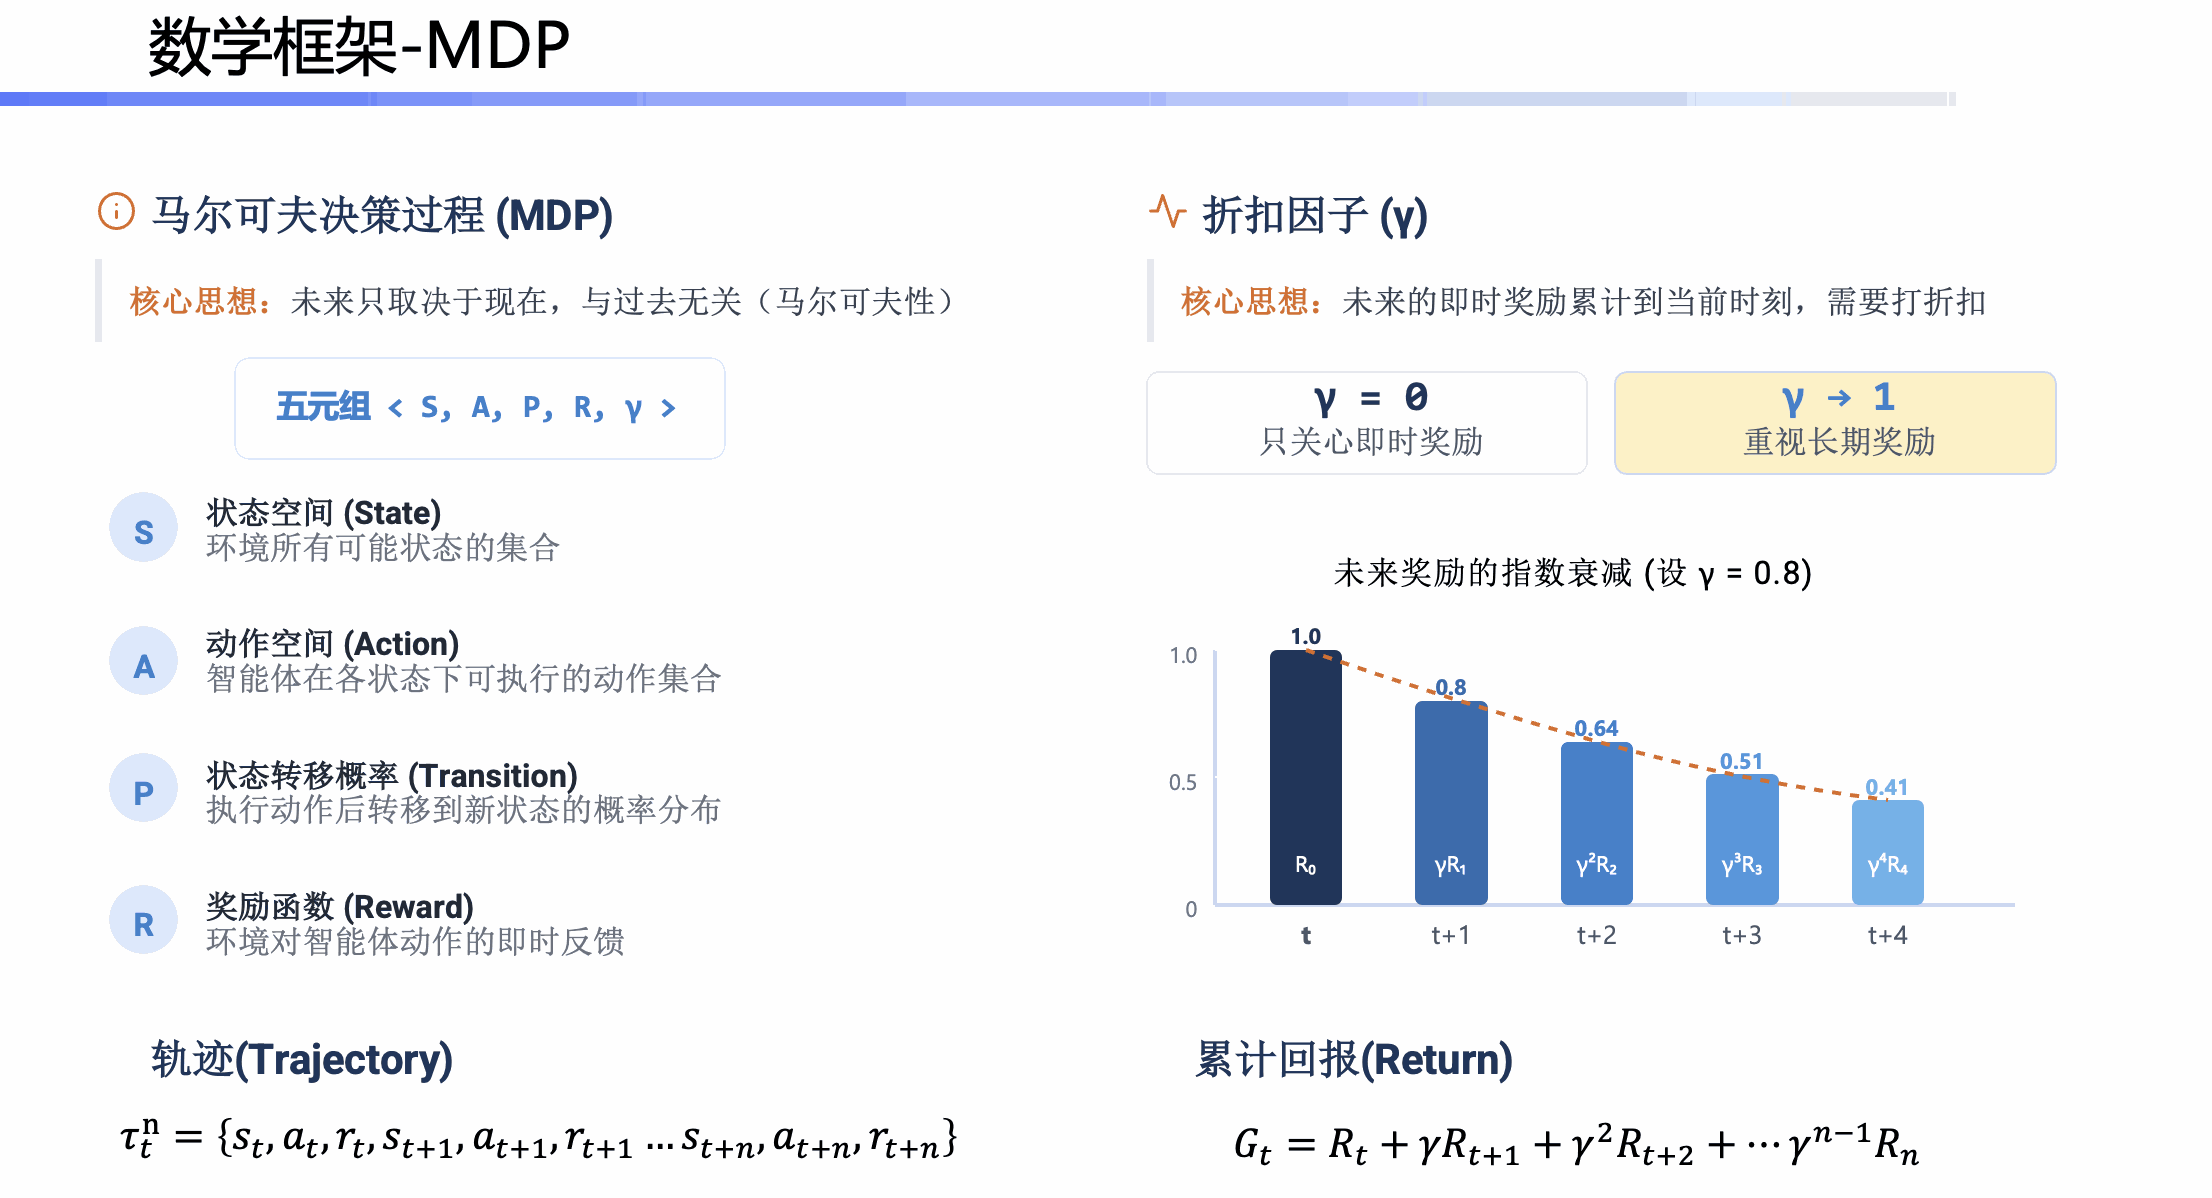
要设计算法,先要有精确的数学语言。强化学习的标准形式化是马尔可夫决策过程(Markov Decision Process, MDP),由一个五元组定义:
| 符号 | 名称 | 含义 |
|---|---|---|
| 状态空间 | 所有可能状态的集合 | |
| 动作空间 | 所有可能动作的集合(离散或连续) | |
| 转移函数 | ,环境的动力学 | |
| 奖励函数 | 执行动作后获得的即时奖励 | |
| 折扣因子 | 未来奖励的衰减系数 |
马尔可夫性
MDP 名字里的"马尔可夫"指的是一个关键假设:
下一个状态只取决于当前状态和当前动作,与更早的历史无关。 这个假设让算法可以只看当前状态做决策,不用背着整段历史,极大简化了问题。它现实吗?取决于状态怎么定义。围棋的棋盘局面是马尔可夫的(历史不影响后续合法走法与胜负判定,除了打劫等少数规则细节);但 Atari 游戏的单帧画面不是马尔可夫的——一张静止的乒乓球画面看不出球在往哪飞。DQN 的解法很直接:把最近 4 帧堆叠起来当作状态,让速度信息显式地进入状态表示。当状态确实无法完全观测时,问题就升级为 POMDP(部分可观测 MDP),需要用 RNN 或信念状态来维护记忆,这留到系列最后再谈。
回报与折扣因子
有了数学框架,就可以用下面的公式来记录一场完整的对局,我们称为一条轨迹(Trajectory/Episode):
智能体要最大化的不是单步奖励,而是累积折扣回报(discounted return):
为什么要有折扣因子 ?三个理由,从实用到数学:
- 数学上保证收敛:如果奖励有界 ,那么 ,无穷级数收敛。没有折扣的话,无限时长任务的回报可能是无穷大,无法比较优劣。
- 表达不确定性:越远的未来越不可信(模型误差、环境变化),打折是合理的风险态度。
- 控制有效视野: 决定了智能体"看多远"。粗略地说,有效视野约为 步。 大约看 10 步, 大约看 100 步。
是一个非常关键、也常被低估的超参数。它太小,智能体变得短视,学不会需要长期铺垫的策略;它太大,回报的方差急剧上升,训练容易发散。它不只是"问题设定"的一部分,更是一个调节偏差-方差的旋钮。
策略与价值函数
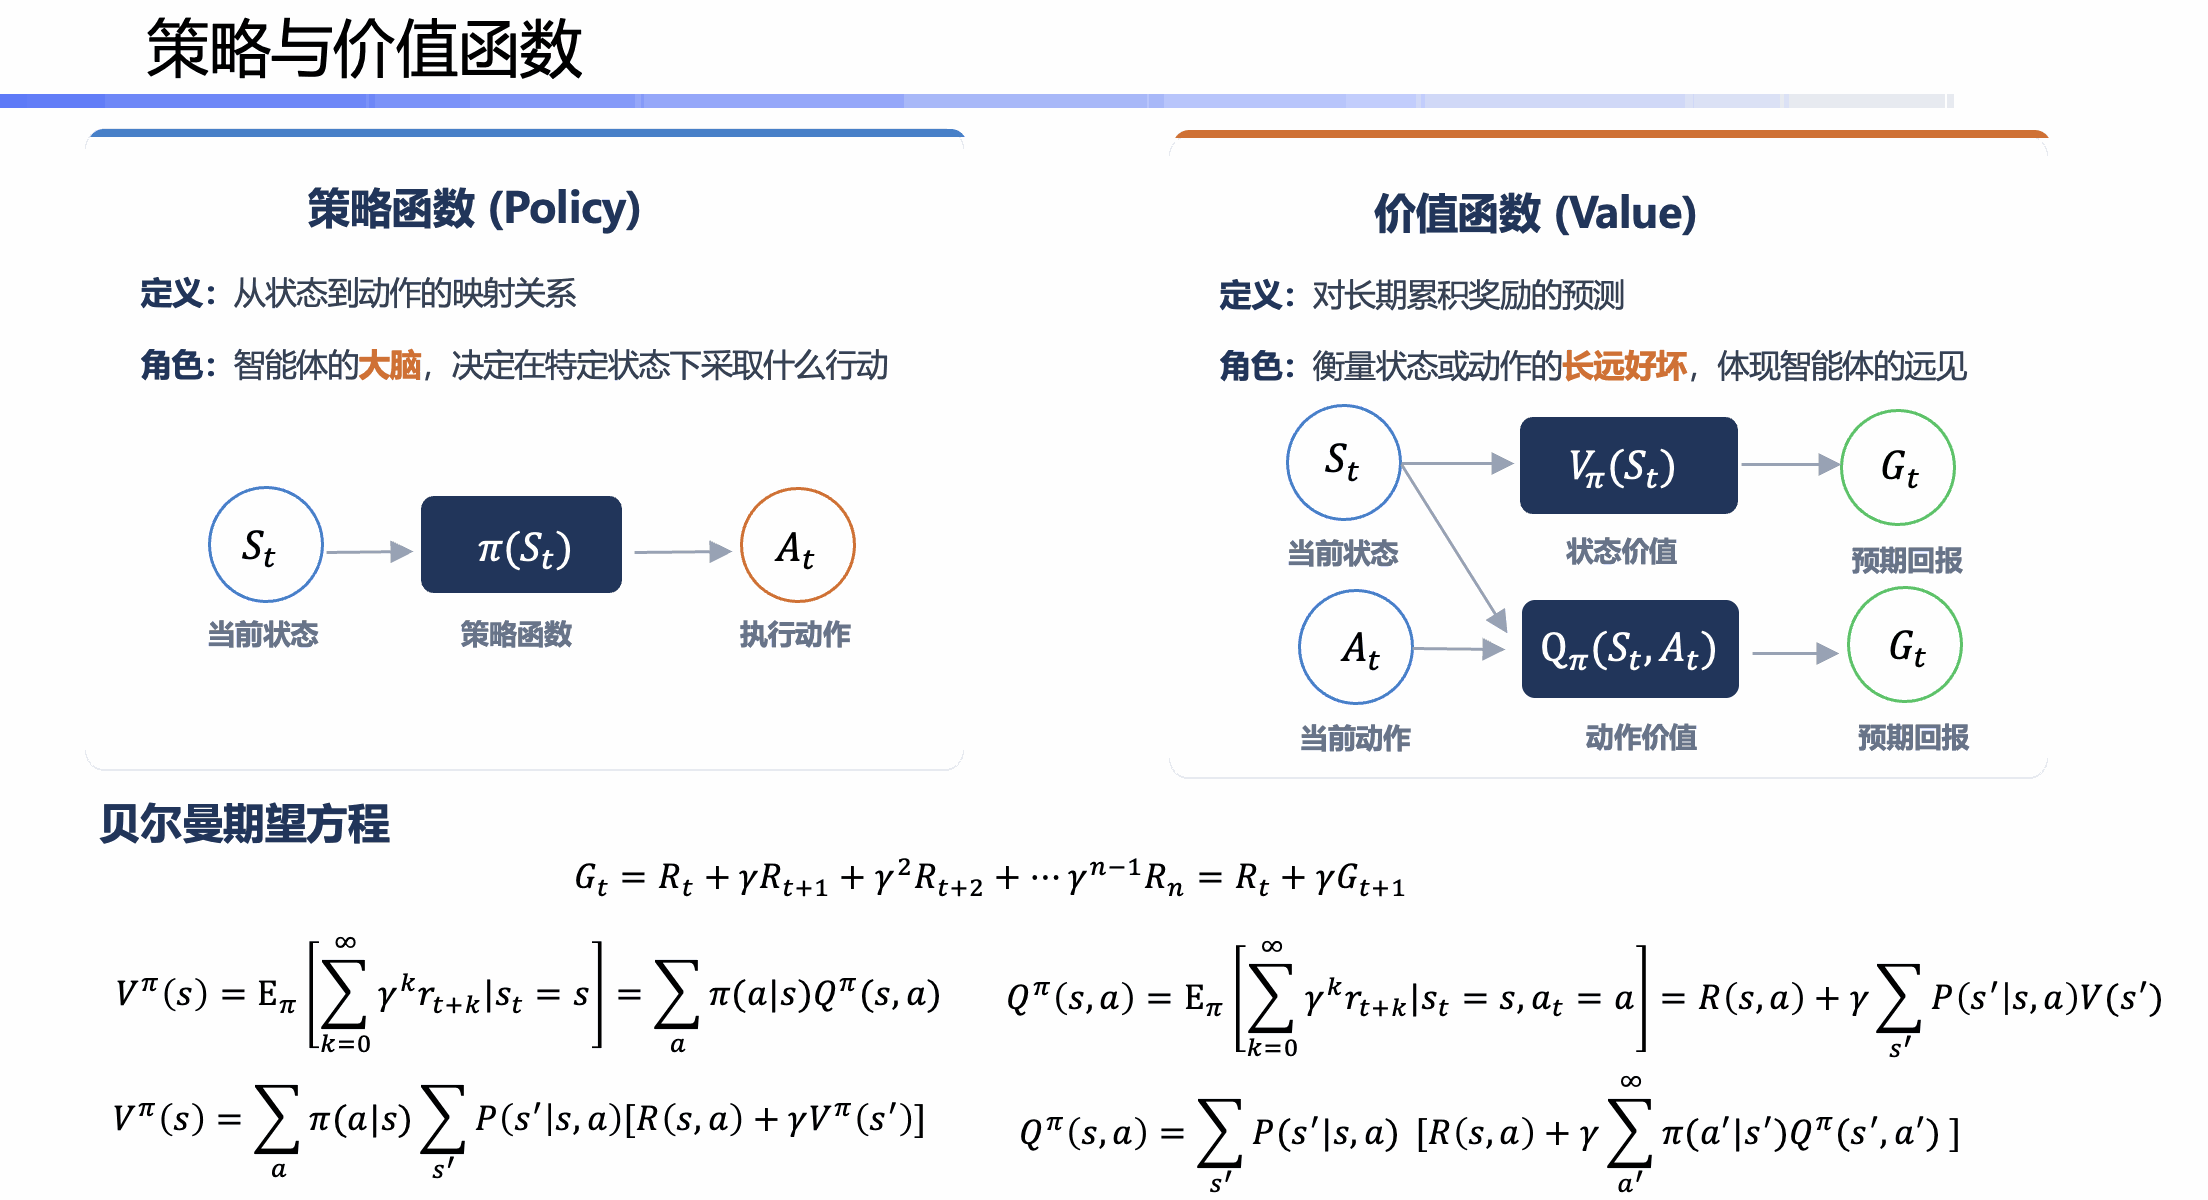
策略
策略(policy) 就是智能体的决策规则,是 MDP 问题的"解",通常用 来表示:
- 确定性策略:,一个状态对应一个固定动作
- 随机策略:,一个状态对应动作上的概率分布
例如在玩迷宫游戏时,可以有一种策略:一直往一个方向走,直到遇到障碍物,就往左转,然后继续走。还可以用另外一种策略:在每个位置上,随机选择一个方向前进。在同一个状态下,采用不同策略,就会导致不同的动作,得到不同的奖励。有了策略后,要如何评价一个策略的好坏? 答案是价值函数。
价值函数
状态价值函数:在状态 出发,之后一直按策略 行动,能拿到的期望回报
动作价值函数:在状态 执行完动作 后,一直按 行动,能拿到的期望回报
两者的关系是对动作求期望:
还有一个非常有用的量,优势函数(advantage function):
它衡量"在状态 选动作 ,比按当前策略平均水平好多少"。优势函数是策略梯度方法的主角,也是把绝对数值变成相对比较、从而降低方差的关键技巧。
贝尔曼期望方程
价值函数的定义里有一个无穷求和,看起来无法计算。但它有一个漂亮的递归结构。把 拆成"第一步 + 剩下的":
两边取期望,得到 贝尔曼期望方程(Bellman expectation equation):
这个方程的意义非常大:它把一个"关于无穷未来的量"变成了"当前奖励 + 下一状态的同类量"的关系。几乎所有强化学习算法都是在以某种方式求解或近似这个方程。
找宝箱示例
用一个 4 格走廊把上面的符号落地。状态 可以行动, 是宝箱(终止状态)。动作只有"左"和"右",撞墙则原地不动。走到 得奖励 ,其余为 。取 。
1 | ┌─────┬─────┬─────┬─────┐ |
情况一:随机策略(左右各 0.5)。列出贝尔曼方程:
这是一个三元线性方程组,解得:
情况二:最优策略(一直向右)。此时 ,,:
两组数字的差距就是"策略有多差"的量化。同时也能直观看到 的作用:距离宝箱每远一步,价值就打一次 的折扣,这就是价值函数如何把延迟的奖励沿时间反向传播到早期状态——迷宫入口之所以有价值,是因为它能通向宝箱。
贝尔曼最优方程
我们真正想要的是最优策略。定义最优价值函数 ,,它们满足 贝尔曼最优方程:
注意期望里的 变成了 。这个小改动威力惊人:一旦拿到 ,最优策略就免费得到了
这就是第二篇 value-based 方法的全部动机:不直接找策略,而是想办法把 估准。
为什么迭代能收敛
把贝尔曼最优方程的右边看成一个算子 ,即 。可以证明 是压缩映射(contraction mapping):
也就是说,每做一次迭代,任意两个价值估计之间的最大差距至少缩小到原来的 倍。由压缩映射定理, 有唯一不动点(正是 ),且从任意初值反复迭代都会收敛到它。这就是"为什么闷头迭代真的有用"的理论依据,也解释了 为何如此重要: 就是收敛速率, 时收敛会变得极慢。
如何求解:动态规划
如果转移函数 和奖励函数 完全已知(比如我们手里就有迷宫地图),MDP 可以直接用动态规划求解,不需要智能体与环境持续交互来进行"学习"。这套方法虽然不能直接用于复杂问题,但它是所有 RL 算法的骨架。
策略评估(policy evaluation):给定 ,反复应用贝尔曼期望方程直到收敛,得到
策略改进(policy improvement):拿到 后,贪心地更新策略
策略改进定理保证 ,即这样改一定不会变差。
策略迭代就是两者交替:评估 → 改进 → 评估 → 改进 …… 直到策略不再变化。价值迭代更干脆,把两步合成一步,直接迭代贝尔曼最优方程:
用上面的 4 格走廊跑价值迭代(初值全 0),过程一目了然:
| 迭代轮次 | |||
|---|---|---|---|
| 0 | 0 | 0 | |
| 0 | 0 | 1.00 | |
| 0 | 0.90 | 1.00 | |
| 0.81 | 0.90 | 1.00 | |
| 0.81 | 0.90 | 1.00 (收敛) |
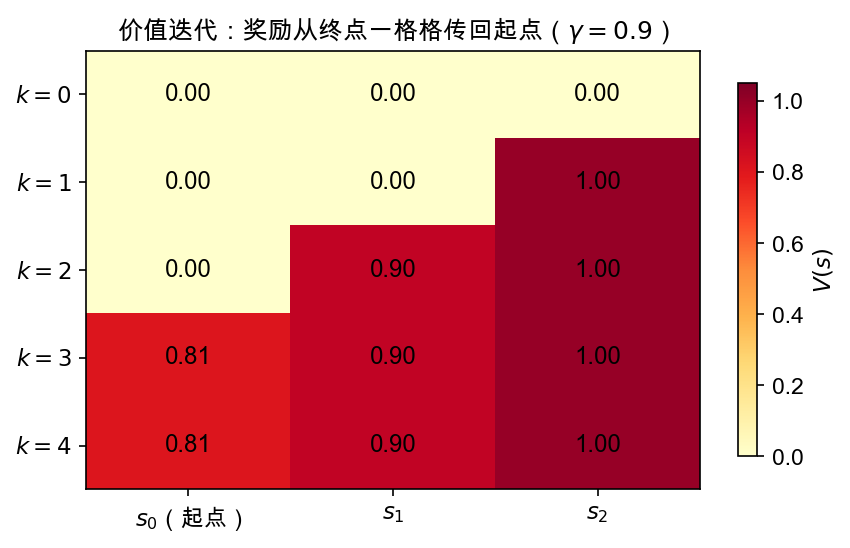
可以清楚看到奖励信号如何从终点一格一格地往起点传播。这个"信息沿时间反向流动"的画面,是理解后面所有 TD 类算法的关键直觉。
现实问题中动态规划为什么不够用?两个原因:
- 模型未知:真实世界里我们几乎不知道 (Atari 的游戏内核、机械臂接触物理),这就需要 model-free 方法(第二、三篇),或者先把模型学出来(第四篇)
- 状态空间爆炸:DP 要遍历所有状态,围棋约 个局面,Atari 的像素状态空间更是天文数字,这就需要函数逼近——用神经网络代替表格,这就是"深度强化学习"里的"深度"
三条技术路线
回到最初的问题:怎么解一个 MDP?按照"我们究竟在学什么"来分,有三条路线。这也是这个系列后三篇的划分依据。
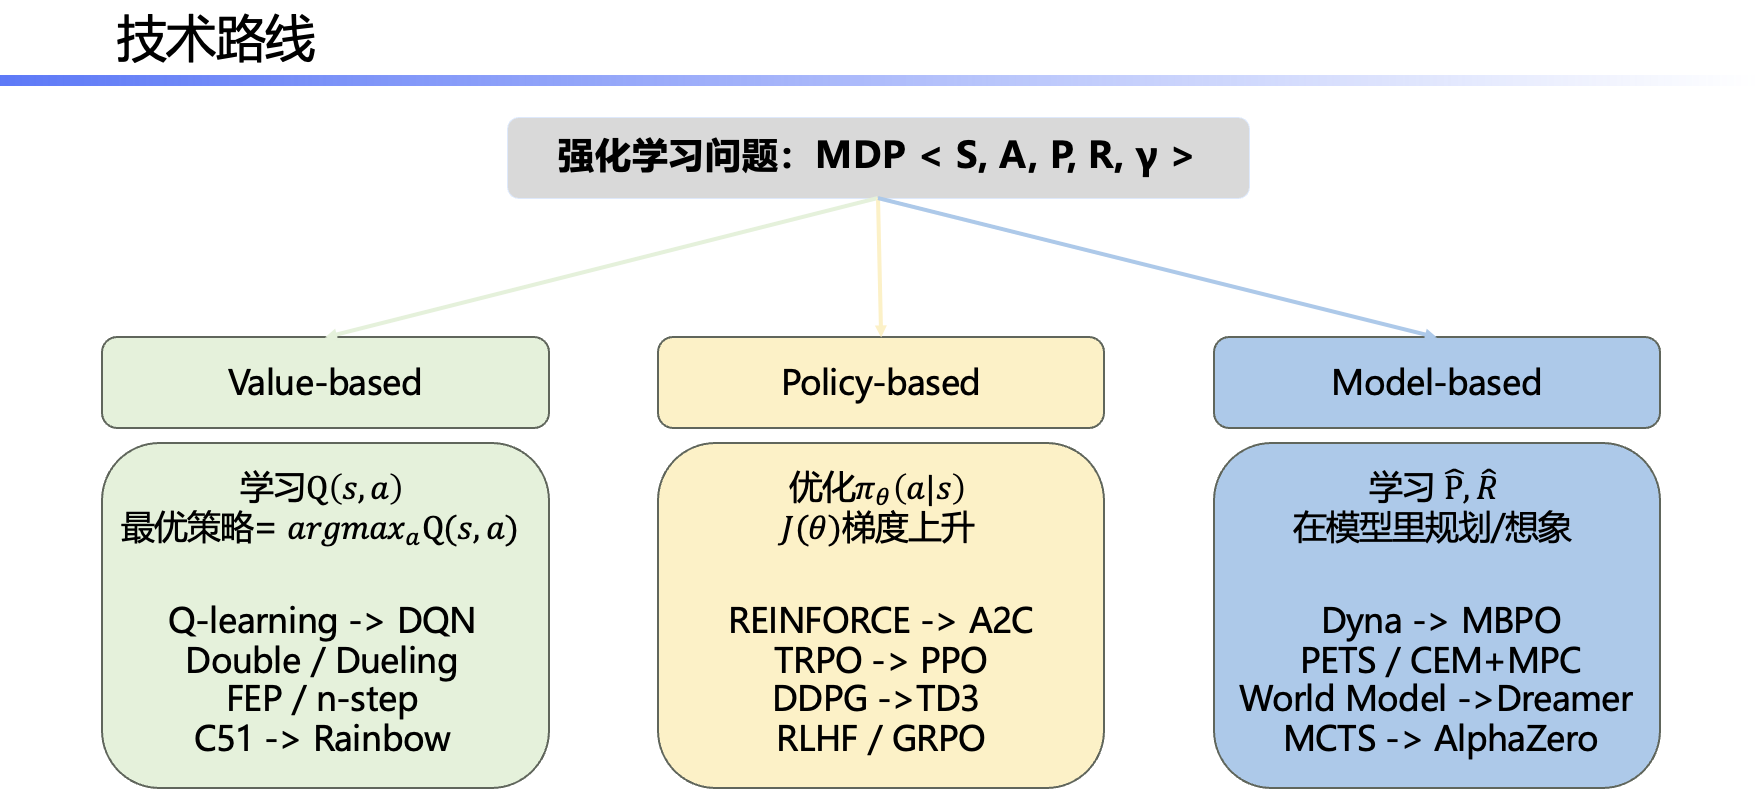
三者并非互斥,现代算法大多是混合体:Actor-Critic 同时学策略和价值;AlphaZero 用模型做规划、用网络估价值、用策略网络剪枝搜索。它们的取舍大致如下:
| 维度 | Value-based | Policy-based | Model-based |
|---|---|---|---|
| 学什么 | |||
| 连续动作 | 困难( 不可解) | 天然支持 | 支持 |
| 随机策略 | 需额外机制 | 天然支持 | 取决于上层 |
| 样本效率 | 中(可用回放池) | 低(多为 on-policy) | 高 |
| 训练稳定性 | 中(自举易发散) | 较好(但方差大) | 依赖模型精度 |
| 计算开销 | 低 | 低 | 高(规划/想象) |
| 典型应用 | 离散动作、Atari | 连续控制、RLHF | 棋类、真机控制 |
算法设计维度
除了"学什么",还有"怎么学"。下面这几个维度彼此正交,组合起来构成了 RL 算法的设计空间。读论文时先把这几个标签打上,往往就能快速定位一个方法的位置。
online vs offline:online 指智能体边交互边学习,能随时用最新策略采新数据;offline(也叫 batch RL)指只给你一个固定的历史数据集,不允许再与环境交互。offline 的困难在于:无法通过试错验证"数据里没出现过的动作"的价值,函数逼近器在这些动作上的外推误差会被 操作系统性放大。
on-policy vs off-policy:区分两个策略:产生数据的 behavior policy 和我们要优化的 target policy 。
- on-policy:,数据必须由当前策略产生,用完即弃(REINFORCE、A2C、PPO)
- off-policy:,可以复用旧数据甚至他人数据(Q-learning、DQN、DDPG、SAC)
off-policy 的样本效率高得多,代价是需要处理分布不匹配。
探索与利用(exploration vs exploitation):利用是选当前认为最好的动作,探索是尝试可能更好的动作。经典权衡策略:
| 方法 | 做法 | 特点 |
|---|---|---|
| -greedy | 以 概率随机、否则贪心 | 简单,但盲目 |
| Boltzmann / softmax | 按 采样 | 按价值高低分配探索 |
| 乐观初始化 | 把 初始化成很大的值 | 自动倾向于试没试过的 |
| 熵正则 | 目标里加 | 保持策略随机性,第三篇详述 |
| 内在动机 | 对"新奇状态"额外奖励 | 应对稀疏奖励 |
泛化与偏差:最后补一个容易被忽略、但实践中极其重要的视角。在数据有限的情况下,强化学习和监督学习一样面临泛化问题,只不过它的表现形式更隐蔽:
- 函数逼近器的容量:网络太大,在有限交互数据上会过拟合到噪声轨迹;太小则无法表达最优价值/策略
- 状态表示:state representation 的好坏往往比算法选择影响更大。把关键信息(如速度)显式编码进状态,比让网络自己从像素里学要省下几个数量级的样本
- 折扣因子 也是正则化:小 相当于限制了考虑的时间跨度,减少了方差(降低过拟合),但引入了偏差(可能学不到长期最优)
- 模型的作用:用学到的模型生成想象数据,本质上是一种数据增强,但模型偏差会引入系统性错误(第四篇的核心矛盾)
这些选择都不是"越大越好"或"越准越好",而是在偏差(bias)和过拟合(overfitting)之间取平衡。当你发现一个 RL 智能体在训练环境表现很好、换个随机种子就崩,多半就是这里出了问题。
符号表
后面几篇会反复用到这些符号,统一列在这里:
| 符号 | 含义 |
|---|---|
| 当前状态、下一状态 | |
| 当前动作、下一动作 | |
| 即时奖励 | |
| 折扣因子 | |
| 一条轨迹 | |
| 从 时刻起的累积折扣回报 | |
| , | 策略、参数化策略 |
| behavior policy(产生数据的策略) | |
| , | 策略 下的状态价值、动作价值 |
| , | 最优价值函数 |
| 优势函数 | |
| TD error, | |
| , | 网络参数、目标网络参数 |
| 策略的目标函数(期望回报) |
小结
- 强化学习与监督学习的根本差异有四点:反馈是评价性而非指导性、数据由自己产生且分布随策略漂移、误差会随时间复合放大、必须主动探索。半监督学习是在补全标签,强化学习是自己造数据、并用贝尔曼方程给自己造标签。
- MDP 五元组 是标准数学框架,马尔可夫性让"只看当前状态决策"成为可能; 既定义了有效视野,也是一个偏差-方差旋钮。
- 贝尔曼方程把"无穷未来的期望回报"变成"当前奖励 + 下一状态价值"的递归关系,是几乎所有 RL 算法的共同起点;压缩映射性质保证了迭代求解会收敛。
- 已知模型时用动态规划(策略迭代/价值迭代)即可求解;现实中模型未知、状态空间巨大,于是分裂出 value-based、policy-based、model-based 三条路线。
下一篇进入 Value-based methods:从表格 Q-learning 出发,看看当 表格换成神经网络后会出什么问题,DQN 的经验回放和目标网络分别修的是哪个 bug,以及 Double、Dueling、优先回放、分布式 RL 这些改进各自解决了什么。
延伸阅读
- Francois-Lavet et al., An Introduction to Deep Reinforcement Learning, arXiv:1811.12560
- Sutton & Barto, Reinforcement Learning: An Introduction (2nd ed.)
- OpenAI Spinning Up in Deep RL