
前两篇讲的 value-based 和 policy gradient 都属于 model-free:它们从不试图理解环境本身,只是在大量试错中总结"什么状态下做什么好"。代价是样本效率极低——DQN 打 Atari 需要上亿帧交互(相当于人类连续玩 40 天),PPO 学会一个简单的机器人步态也要百万级交互。
而人类学开车不需要撞一万次。原因很清楚:我们脑子里有一个世界模型。看到前方有个坑,不用真的开过去才知道会颠,可以先在想象里推演一遍。
这就是 Model-based RL 的全部动机:
与其在真实世界里反复试错,不如先学出环境的动力学 ,然后在模型里"想象"和"规划"。
它是三条路线中样本效率最高的一条,也是最难做对的一条——因为它引入了一个 model-free 方法完全不存在的新问题:模型误差。这一篇讲清这套方法怎么做、卡在哪,最后给整个系列收个尾。
什么是 model-based
定义与两种用法
所谓"模型",就是对环境动力学的一个可查询的近似:
有了它,我们就可以在不接触真实环境的情况下问"如果我这么做会怎样"。模型有两种截然不同的用法,Sutton 把它们叫做:
| 用法 | 名称 | 做法 | 代表 |
|---|---|---|---|
| 决策时规划 | decision-time planning | 每次要行动时,在模型里前向搜索,当场算出这一步该做什么 | MCTS、MPC |
| 后台规划 | background planning | 用模型生成想象数据,喂给 model-free 算法去更新策略/价值 | Dyna、MBPO、Dreamer |
前者把模型当"沙盘",临场推演;后者把模型当"数据生成器",离线练兵。两者可以叠加(AlphaZero 就同时做了两件事)。
为什么样本效率高
一个直观的解释:model-free 方法从一条经验 里只提取了一个标量信号(TD error 或者回报权重)。而学模型时,同样一条经验提供的是整个 向量的监督信号——信息量高出几个数量级。
更重要的是,模型是与任务无关的:环境动力学不随奖励函数改变。所以同一个模型可以复用到新任务上(换奖励函数重新规划即可),而 函数和策略都是任务专用的。这是 model-based 方法在多任务、迁移场景下的巨大优势。
典型的量级对比(连续控制基准任务):
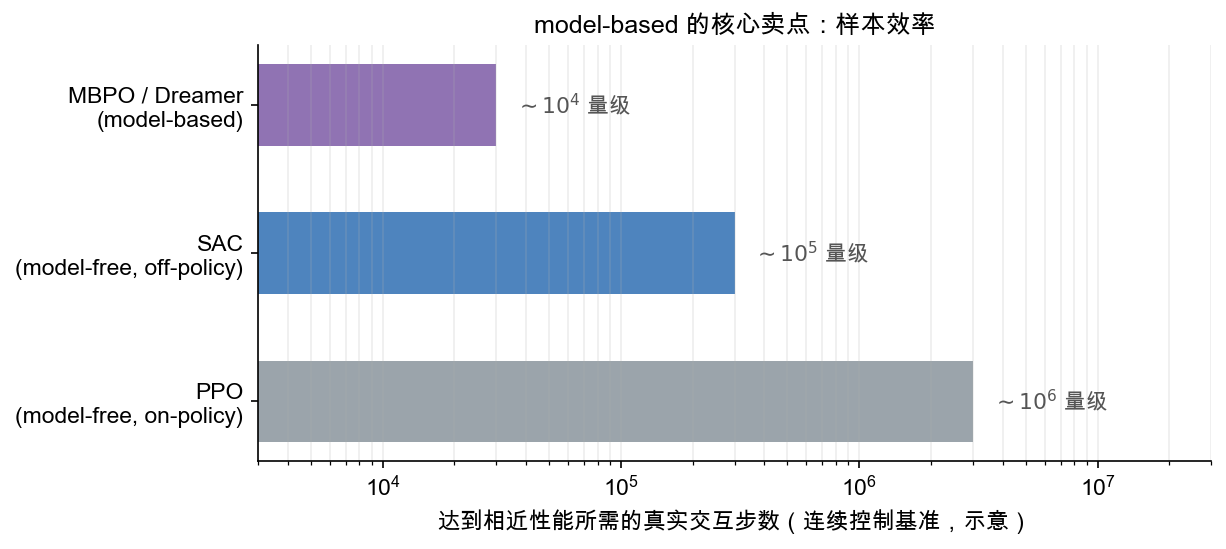
代价则是计算量:规划和想象都要反复前向模型,AlphaZero 每步要跑几百次 MCTS 模拟。这是一个"用算力换样本"的交易——当真实交互很贵(真机、临床、金融)而算力便宜时,这笔交易非常划算。
有了模型怎么用:规划
先假设模型是完美的(比如棋类游戏,规则本身就是精确模型),只讨论怎么用。
已知模型的经典解法
如果状态空间小,第一篇讲过的动态规划就够了:价值迭代、策略迭代,直接把贝尔曼最优方程迭代到收敛。状态空间大时行不通,于是有了下面的近似方法。
轨迹优化与 MPC
在连续控制里,最常用的框架是 模型预测控制(MPC):
1 | 每一个时间步: |
第 3、4 步是 MPC 的精髓:只执行第一步,然后重新规划。这样即使模型有误差,每一步都会被真实观测"纠偏",误差不会一直累积下去。这是对抗模型误差最有效、最朴素的机制。
具体怎么搜索那段动作序列?
| 方法 | 做法 | 特点 |
|---|---|---|
| 随机打靶(random shooting) | 随机采 1000 条动作序列,选预测回报最高的 | 极简单,维度高时效率低 |
| CEM(交叉熵方法) | 采样 → 保留最好的 10% → 用它们拟合新的高斯分布 → 重新采样,迭代几轮 | 实践中最常用 |
| MPPI | 按回报做指数加权平均,而非硬性截断 | 更平滑 |
| iLQR / DDP | 对动力学做局部线性化、对奖励做二次近似,解析求解 | 高效但需要可微模型、易陷局部解 |
CEM 的实现只有十几行,效果却出奇地好:
1 | def cem_plan(model, s0, horizon=25, n_samples=500, n_elite=50, n_iters=5): |
MCTS:搜索与神经网络的结合
离散动作、树状结构的问题(棋类)用 蒙特卡洛树搜索(MCTS)。它的四个步骤循环:
1 | 根节点 = 当前局面 |
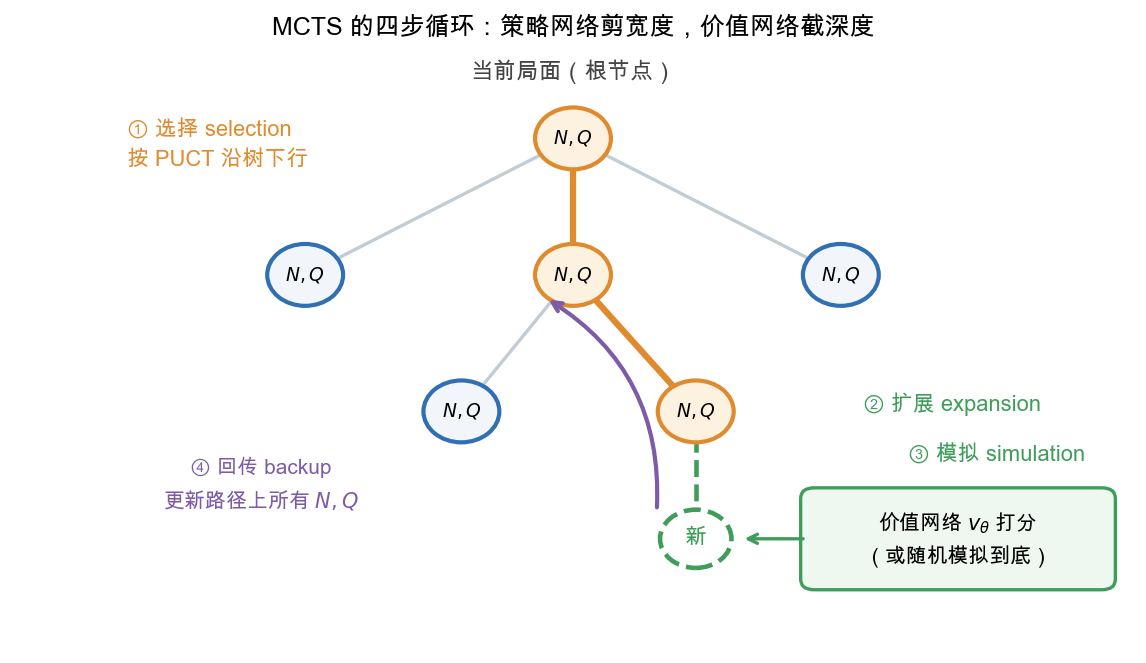
第 1 步的选择规则是核心。经典 UCT:
前一项是利用(当前估计的价值),后一项是探索(访问次数少的加分)。AlphaGo/AlphaZero 用的是 PUCT,把策略网络的先验 加进来指导搜索:
AlphaZero 的整体设计非常值得体会,它把三样东西拧在了一起:
- 模型:围棋规则就是完美模型,免费获得
- 神经网络 :策略头 给搜索提供先验(剪枝,避免宽度爆炸),价值头 替代随机模拟到底(截断深度,避免深度爆炸)
- 自我对弈:MCTS 搜索出的动作分布 比网络原始输出 更强(搜索本身就是一次策略改进),于是把 当作标签去训练网络。网络变强 → 搜索变强 → 标签更好 → 网络更强
这是全书最漂亮的思想之一:把规划器当作策略改进算子(policy improvement operator),用搜索的结果去监督学习网络。 它把 RL 问题转化成了一个不断自我提升的监督学习循环。
MuZero:只学"对决策有用"的模型
AlphaZero 依赖规则已知。MuZero 把这个限制去掉了,做法非常有启发性:它学一个模型,但完全不预测观测。三个网络:
隐状态 不需要能重建画面,它只需要满足一件事:在它上面展开搜索时,预测出来的奖励、价值、策略和真实的一致。训练损失就是这三项的预测误差。
这叫 价值等价(value equivalence) 原则:模型不必是环境的忠实复制品,只要在"对决策有用"的量上与环境等价就够了。
为什么这很重要?想想用像素级模型玩 Atari:为了预测下一帧,模型要花巨大容量去建模背景纹理、云朵飘动这些与决策完全无关的细节,而真正关键的几个像素(球的位置)反而被平均掉了。MuZero 直接跳过了这个陷阱。"不要试图预测一切,只预测有用的东西"——这可能是整个 model-based 领域最重要的教训。
怎么学模型
现在讨论模型本身怎么来。表面上这是个标准的监督学习问题,实际上有几个非常棘手的坑。
朴素做法与复合误差
最直接的做法:把交互数据当训练集,学一个一步预测器
(实践中常用预测差值 而不是 本身,因为差值的量级小、更好学。)
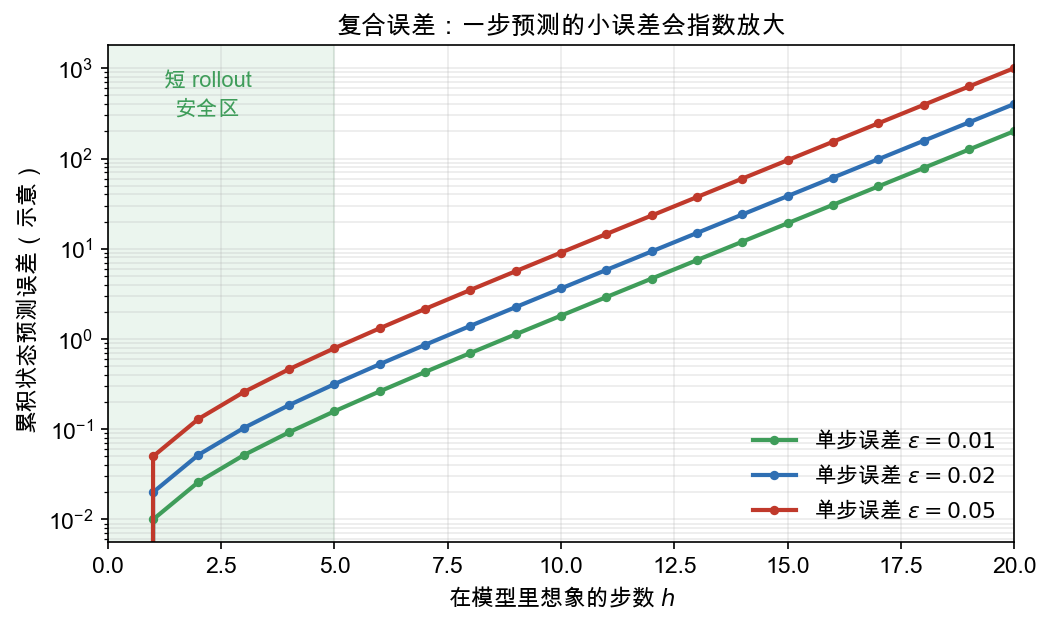
问题在于:训练时是一步预测,使用时却要多步 rollout。第 1 步的预测误差成为第 2 步的输入,模型在这个"略微失真"的输入上从未训练过,误差被放大,再传给第 3 步……误差随步数指数级放大,这就是 复合误差(compounding error)。
1 | 真实轨迹: s0 ──→ s1 ──→ s2 ──→ s3 ──→ s4 |
更糟的是最后一句:规划器/策略会主动去攻击模型的错误。如果模型在某个状态错误地预测"这里能拿 100 分",优化器会兴高采烈地找到这条路径并疯狂利用它。这被称为 model exploitation,是 model-based RL 失败的头号原因。它和第三篇 DDPG 里"策略去攻击 critic 的高估"是同一类病症。
应对一:显式建模不确定性
既然模型必然有错,那至少要知道自己哪里不确定。两条主流做法:
- 高斯过程(PILCO):用 GP 建模动力学,天然给出预测的均值和方差,然后把不确定性解析地传播到多步预测里,在"期望回报"上求梯度。样本效率惊人(几十次交互就能学会倒立摆),但 GP 无法扩展到高维和大数据。
- 概率集成(PETS):训 个(如 5 个)神经网络,每个输出高斯分布的均值和方差,初始化和数据顺序不同。规划时,每条候选轨迹在随机选取的模型上推演——如果各个模型意见一致(认知不确定性小),说明这个区域数据充足可信;如果分歧很大,那么该轨迹的平均回报会自动被拉低。这就实现了自动的保守规划。
区分两种不确定性对理解这套方法很重要:
| 类型 | 来源 | 能否消除 | 建模方式 |
|---|---|---|---|
| 偶然不确定性(aleatoric) | 环境本身随机 | 不能 | 网络输出方差 |
| 认知不确定性(epistemic) | 数据不够,模型不知道 | 能(多采数据) | 集成 / 贝叶斯 |
model exploitation 攻击的正是认知不确定性大的区域,所以集成(而不只是输出方差)是必需的。
应对二:在隐空间里建模
高维观测(图像)直接做像素预测既贵又没必要。隐空间世界模型的思路是:先学一个编码器把观测压成低维隐变量 ,再在 空间里学动力学。
World Models(2018) 的三件套非常清晰:
1 | V (VAE): 图像 o ──编码──→ 低维隐向量 z(如 32 维) |
有意思的是,它训练策略时完全在"梦里"进行(不接触真实环境),学完直接迁移回真实环境就能用。控制器只有几百个参数,用进化算法(CMA-ES)就能优化。
Dreamer 系列 把这套做法工程化到了 SOTA 水平,几个关键设计:
- RSSM:隐状态同时包含确定性部分(RNN 隐状态)和随机部分(隐变量),前者负责长程记忆,后者负责建模随机性
- 在隐空间中想象训练:从回放池里的真实状态编码出 ,然后在隐空间里 rollout 15~20 步,用这些想象轨迹训练 actor 和 critic(完全不需要解码回图像,极快)
- 解析梯度:因为整个想象过程可微,策略梯度可以直接穿过动力学模型回传,比第三篇的 log-derivative 估计方差低得多
- 重建作为辅助任务:Dreamer 仍然重建图像(作为表示学习的信号),但 DreamerV3 加入了大量归一化技巧,使得一套超参能横跨 150 多个差异极大的任务
Dreamer 的成绩说明了一件事:在隐空间里做梦,是当前把样本效率推到极限的最有效路径。
应对三:让规划本身可微
还有一类思路:不把"学模型"和"规划"分成两步,而是把规划过程本身写成神经网络的一部分,端到端训练。
- VIN(Value Iteration Network):注意到网格世界里的价值迭代,其实等价于"卷积 + max-pooling"的反复迭代。于是把 轮价值迭代实现为一个 层的 CNN,整个"规划器"就是可微的,直接用最终决策的损失去训练。
- Predictron / VPN:不要求模型能预测状态,只要求它多步展开后预测的价值和奖励是准的——和 MuZero 的价值等价思想一脉相承。
这些方法的共同哲学是:模型的训练目标应该对齐它的使用目的。用监督学习的一步预测误差去训模型,然后指望它在多步规划里表现好,这本身就是目标错配。
与 model-free 的结合
纯 model-based 的渐近性能通常不如 model-free(因为模型误差最终会成为瓶颈),而 model-free 的样本效率又太低。现代方法几乎都是两者的混合。
Dyna 风格:模型当数据增强
Dyna 是最经典的框架,Sutton 在 1991 年就提出了:
1 | 循环: |
第 4 步是关键:一次真实交互可以配上 次(如 20 次)想象更新,样本效率直接提升一个量级。本质上,模型是一个数据增强器。
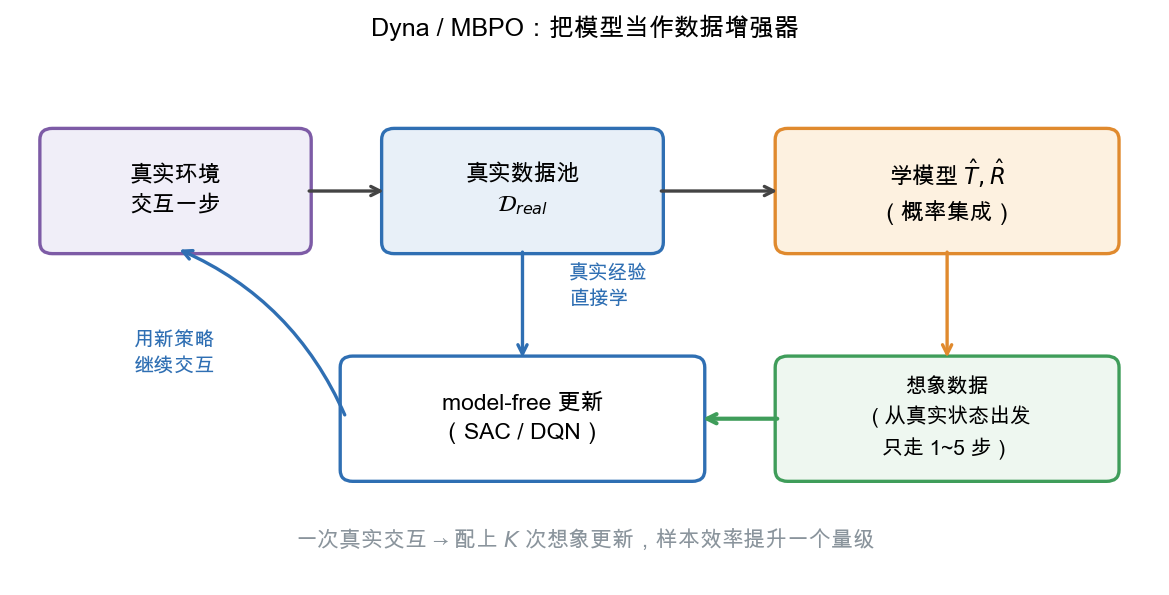
MBPO 是 Dyna 的现代版,两个关键设计正好对应前面讲的两个坑:
- 短 rollout:想象轨迹从回放池中的真实状态出发,只走 1~5 步就停。因为复合误差是指数增长的,短 rollout 把误差控制在可接受范围内。论文里有个理论结果:性能改进的下界取决于"模型误差 × rollout 长度",于是存在一个最优长度。
- 概率集成模型 + SAC:用 PETS 式的集成建模不确定性,用 SAC(第三篇)作为 model-free 部分消费想象数据。
MBPO 在 MuJoCo 上用大约 1/10 的样本达到了 SAC 的渐近性能,是这条路线上最实用的算法之一。
规划作为策略改进算子
前面讲 AlphaZero 时提过这个思想,它可以推广:
1 | 网络给出策略 π_θ ──→ 规划器(MCTS/CEM)在模型里搜索 ──→ 更好的策略 π_plan |
这叫 Expert Iteration(ExIt):搜索扮演"专家"的角色,网络通过模仿这个专家来提升,提升后的网络又让搜索变得更强。Dreamer 里的"想象训练"、MuZero 的自我对弈都可以放进这个框架理解。
把规划结果当特征
还有一类更"软"的结合方式:不完全信任模型,只把它的输出当作额外信息。
- I2A(Imagination-Augmented Agents):用模型 rollout 出几条想象轨迹,把它们编码成向量,和真实观测一起喂给策略网络。策略自己学着判断该信任想象多少——模型不准时它可以学着忽略。这个设计对模型误差非常鲁棒。
- VPN(Value Prediction Network):把模型的多步价值预测作为规划信号,但不要求状态预测准确。
离线设定下的悲观主义
在 Offline RL 里,model-based 方法反而有独特优势:可以用模型生成数据集之外的状态,缓解覆盖不足。但 model exploitation 的风险也更大(没有真实交互来纠偏)。主流方案是悲观:
- MOPO / MOReL:在奖励里减去一个与模型不确定性成正比的惩罚项 。这样策略会自动避开模型没把握的区域,等价于优化真实回报的一个下界。
注意这和第二篇的 CQL、第三篇 TD3 的双 critic 取最小是同一个思想的不同实现:面对不确定,就假设最坏。这条原则贯穿了整个深度 RL 的稳定性工程。
三条路线的最终对比
| 维度 | Value-based | Policy gradient | Model-based |
|---|---|---|---|
| 学什么 | (+ 策略/价值) | ||
| 样本效率 | 中 | 低(on-policy)/ 中(SAC) | 高 |
| 渐近性能 | 高 | 高 | 受模型误差限制 |
| 决策时计算量 | 极低(一次前向) | 极低 | 高(要搜索/推演) |
| 连续动作 | 困难 | 天然支持 | 支持 |
| 稳定性风险 | 过估计发散 | 高方差、策略崩塌 | model exploitation |
| 任务迁移 | 差( 绑定任务) | 差 | 好(动力学与奖励无关) |
| 可解释性 | 中(能看 值) | 低 | 高(能看想象的轨迹) |
| 典型代表 | Rainbow、R2D2 | PPO、SAC | AlphaZero、MuZero、Dreamer |
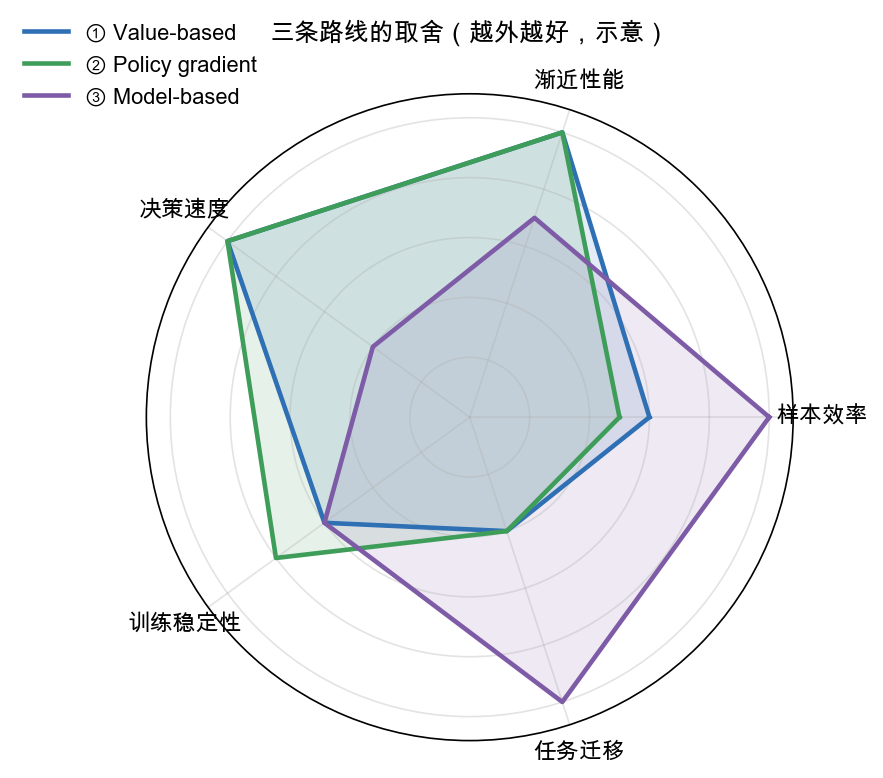
选型建议:
- 离散动作、有大量交互预算、要冲榜 → Rainbow 系
- 连续控制、能大量仿真 → SAC(最省心);需要严格稳定或超大规模并行 → PPO
- 真机交互昂贵、仿真极慢 → MBPO / Dreamer
- 有精确模型(棋类、组合优化、调度) → MCTS + 神经网络
- 只有历史数据、不能交互 → Offline RL(CQL / IQL / MOPO)
- 需要一个模型服务多个任务 → model-based
系列收尾:那些还没解决的问题
四篇文章覆盖了深度 RL 的主干,但真实世界里还有一堆硬骨头。这里列出来,作为进一步阅读的地图。
探索:稀疏奖励下的死局
前面所有方法都假设"随机试探迟早能碰到奖励"。但在 Montezuma's Revenge 这类游戏里,需要精确执行几十个动作才能拿到第一个奖励,随机探索的成功概率是天文数字的倒数。主流思路是内在动机(intrinsic motivation):给"新奇"本身发奖励。
| 方法 | 新奇性怎么度量 |
|---|---|
| Count-based | 状态访问次数的倒数(高维时用哈希或密度模型近似) |
| ICM | 用一个前向模型的预测误差当奖励——"预测不准说明没见过" |
| RND | 用一个随机固定网络作为目标,预测它的误差当奖励(巧妙避开了随机噪声陷阱) |
| Go-Explore | 显式记住去过的有趣状态,先"返回"再从那里探索 |
注意 ICM 有个著名的失效模式:噪声电视(noisy TV)问题——如果环境里有个永远预测不准的随机噪声源,智能体会痴迷地盯着它看。RND 的设计正是为了绕开这一点。
部分可观测与记忆
真实世界几乎从不满足马尔可夫性(第一篇讲过)。处理 POMDP 的办法:
- 拼接历史帧(DQN 的做法,只能处理很短的依赖)
- 循环网络维护隐状态(R2D2、Dreamer 的 RSSM)
- 显式维护对隐状态的信念分布(理论优雅但难扩展)
- Transformer 处理长序列(Decision Transformer 系列,把 RL 变成序列建模问题)
泛化、迁移与元学习
一个在训练关卡上表现完美的智能体,换个随机种子或换一张地图往往就崩了。RL 的过拟合比监督学习更隐蔽(第一篇的偏差-过拟合权衡)。研究方向包括:程序化生成的训练环境(Procgen)、数据增强、域随机化(sim-to-real 的标准做法)、以及元学习(学会快速适应新任务)。
多智能体
多个智能体同时学习时,每个智能体眼中的"环境"包含了其他正在变化的智能体,平稳性假设直接失效。这带来了博弈论层面的新问题(纳什均衡、合作与竞争、通信协议的涌现),代表工作有 AlphaStar、OpenAI Five。
评测与复现性
这是一个很实际的忠告。深度 RL 的实验方差大得离谱:同一份代码、同一组超参、只换随机种子,最终性能可能相差数倍。所以:
- 至少跑 5~10 个种子,报告均值和置信区间(而不是最好的那条曲线)
- 注意实现细节的影响可能超过算法本身(第三篇讲过 PPO 的例子)
- 用标准化的基准和评测协议(Atari 100k、MuJoCo、Procgen、D4RL)
现实落地的挑战
原综述最后一章讨论了把深度 RL 用到真实系统时的几个核心困难,都很中肯:
- 奖励设计(reward shaping):写出一个真正对齐意图的奖励函数极其困难。奖励作弊无处不在——赛艇游戏里刷分的智能体宁愿在原地转圈撞补给包也不去终点。RLHF 里的 KL 惩罚(第三篇)就是在对抗这个问题。
- 安全探索:真机不能通过"摔坏一千次"来学习。需要安全约束、可恢复性保证。
- Sim-to-real gap:仿真里学会的策略搬到真机上失效。域随机化、系统辨识、以及本篇的 model-based 方法都是应对手段。
- 数据效率与冷启动:这也是 offline RL 和 model-based RL 最有商业价值的地方。
和神经科学的呼应
最后一个有趣的视角:RL 的很多概念与大脑的机制惊人吻合。多巴胺神经元的放电模式被发现编码的正是 TD error(Schultz 等人的经典实验);大脑基底神经节的功能类似 model-free 的习惯性学习,而前额叶皮层与海马体的"心理模拟"更像 model-based 的规划。人类在熟练后从"深思熟虑"切换到"下意识反应",很像从 model-based 逐渐 amortize 到 model-free 的过程。
全系列一图流
1 | ┌──────────────────────────────────────────────────────────────────────┐ |
小结
- Model-based RL 的核心是学出 ,用法有两种:决策时规划(MCTS、MPC)和后台规划(Dyna 式生成想象数据)。它样本效率最高,且模型与奖励无关因而易于迁移,代价是决策时计算量大。
- 有模型时的规划工具:连续动作用 MPC + CEM(只执行第一步、每步重新规划,天然抗模型误差),离散/树结构用 MCTS。AlphaZero 的关键洞察是把搜索当作策略改进算子,用搜索结果监督网络,形成自我提升循环。
- 学模型的头号敌人是复合误差与model exploitation(优化器专挑模型的错误去利用)。三类解药:显式建模不确定性并保守规划(PETS、MOPO)、缩短 rollout(MBPO)、以及只学"对决策有用的模型"(MuZero 的价值等价、Dreamer 的隐空间想象)。
- 一条贯穿整个深度 RL 的原则:面对不确定,就假设最坏。Double DQN 的解耦、TD3 的双 critic 取最小、CQL 压低未见动作、MOPO 的不确定性惩罚,全是同一思想的不同外衣。
- 三条路线不是竞争关系而是可组合的模块。Actor-Critic 融合了前两条,AlphaZero 与 Dreamer 三条全占。选型的真正依据是:动作空间形态、交互成本、算力预算、是否需要迁移。
到这里,这个四篇的系列就结束了。回头看,强化学习的全部工程史几乎都在做同一件事:在信息极其稀缺(只有标量奖励)的条件下,尽可能榨取每一次交互的价值,同时不让自己被自己的估计误差骗到。
延伸阅读
- Francois-Lavet, Henderson, Islam, Bellemare, Pineau. An Introduction to Deep Reinforcement Learning. arXiv:1811.12560
- Sutton & Barto. Reinforcement Learning: An Introduction (2nd ed.) —— 第 8 章专门讲 model-based 与 Dyna
- Moerland, Broekens, Jonker. Model-based Reinforcement Learning: A Survey. arXiv:2006.16712
- Silver et al. Mastering the game of Go without human knowledge (AlphaGo Zero);Schrittwieser et al. MuZero
- Hafner et al. Dream to Control / DreamerV3
- Janner et al. When to Trust Your Model: Model-Based Policy Optimization (MBPO)
- OpenAI Spinning Up in Deep RL —— 最好的代码入门