上一篇Value-based 方法结束在一堵墙前面:DQN 家族的所有操作都依赖 argmaxaQ(s,a),而当动作是机械臂的 7 个连续关节力矩时,这个 argmax 变成了一个每一步都要重解的非凸优化问题。
这一篇讲的路线,思路极其直接:
既然我们最终要的就是策略,为什么不直接把策略参数化成 πθ(a∣s),然后对"期望回报"求梯度、做梯度上升?
这就是 Policy gradient(策略梯度) 方法。它绕开了 argmax,天然支持连续动作和随机策略,代价是引入了一个新的头号敌人:方差。从 REINFORCE 到 PPO 的整条演进史,基本就是一部"降方差 + 控制更新步长"的历史。最后我们会看到,今天训练大语言模型的 RLHF 用的正是这条路线上的方法。
目标函数与策略梯度定理
我们到底在优化什么
把策略参数化为 πθ(a∣s)(比如一个神经网络,离散动作时输出 softmax 概率,连续动作时输出高斯分布的均值和方差)。一条轨迹 τ=(s0,a0,r0,s1,…) 出现的概率是
pθ(τ)=p(s0)t∏πθ(at∣st)T(st,at,st+1)
优化目标就是期望回报:
J(θ)=Eτ∼pθ[G(τ)]=Eτ∼pθ[t∑γtrt]
我们想做的是 θ←θ+η∇θJ(θ)。困难在于:J 里的期望是对一个依赖 θ 的分布取的,而且中间还夹着我们完全不知道的环境动力学 T。怎么求梯度?
log-derivative trick
关键是一个恒等式(也叫 score function trick):
∇θpθ(τ)=pθ(τ)∇θlogpθ(τ)
于是
∇θJ(θ)=∇θ∫pθ(τ)G(τ)dτ=∫pθ(τ)∇θlogpθ(τ)G(τ)dτ=Eτ∼pθ[∇θlogpθ(τ)G(τ)]
再把 logpθ(τ) 展开:
logpθ(τ)=logp(s0)+t∑logπθ(at∣st)+t∑logT(st,at,st+1)
注意奇迹发生了:p(s0) 和 T 都不含 θ,求梯度时直接消失。这意味着我们完全不需要知道环境模型,就能算出梯度:
∇θJ(θ)=E[(t∑∇θlogπθ(at∣st))G(τ)]
这就是 策略梯度定理(的一个形式)。它可以直接用采样来估计:跑 N 条轨迹,把上式的期望换成平均。
直觉解读:加权的最大似然
这个公式的形式非常眼熟。回忆监督学习里的分类任务,交叉熵损失的梯度是 ∇θlogπθ(ylabel∣x)——提高正确标签的对数概率。
策略梯度的形式几乎一样,只是把"正确标签"换成"我实际采取的动作",并且乘上了一个权重 G(τ):
∇θJ≈N1i∑t∑∇θlogπθ(ati∣sti)⋅Gi
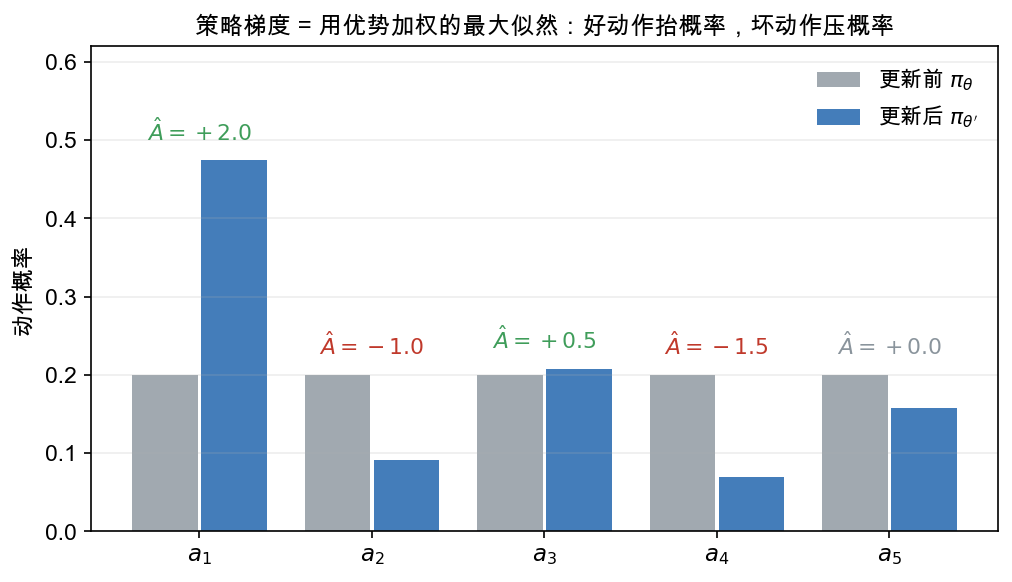
所以它就是用回报加权的最大似然:
- 回报高(G>0 且大)→ 大力提高这些动作的概率:"以后多这么干"
- 回报低(G<0)→ 降低这些动作的概率:"以后别这么干"
这也直接解释了它和监督学习的关系(呼应第一篇):监督学习是"告诉你该做什么",策略梯度是"让你多做已经做过的好事"。它只会强化已经尝试过的行为,永远发现不了没试过的更优解——所以探索必须由别的机制提供(后面的熵正则)。
REINFORCE 与它的方差灾难
算法
最原始的策略梯度算法叫 REINFORCE(也叫 Monte-Carlo policy gradient):
1
2
3
4
5
6
| 重复:
1. 用当前策略 π_θ 跑 N 条完整轨迹
2. 对每条轨迹算回报 G
3. 计算梯度估计 ĝ = (1/N) Σ_i Σ_t ∇log π_θ(a_t|s_t) · G^i
4. θ ← θ + η · ĝ
5. 丢掉所有数据(on-policy!)
|
第 5 步值得注意:数据一旦用过就不能再用,因为梯度公式里的期望是对当前策略取的。这让 policy gradient 天生比 DQN 的样本效率低得多。
两个问题
问题一:用整条轨迹的回报,信用分配极差。 公式里每个时刻的 ∇logπ 都乘同一个 G(τ)。假设一条轨迹总分很高,但其中第 50 步其实是个愚蠢动作——它也会被一并强化。
第一个修正来自因果性:t 时刻的动作不可能影响 t 之前的奖励,所以权重应该只用"从 t 时刻起的回报":
∇θJ=E[t∑∇θlogπθ(at∣st)Gt],Gt=k≥t∑γk−trk
这一步不改变期望(无偏),但去掉了大量无关噪声,方差立降。
问题二:方差还是大得离谱。 考虑一个所有奖励都是正数的任务(比如每步 +1)。那么所有 Gt>0,于是所有动作的概率都被"提高"——只是提高的幅度不同。由于概率必须归一化,最终效果只取决于幅度的相对差异,而这个差异被巨大的绝对值淹没了。梯度信号的"信噪比"极低。
基线:最重要的降方差技巧
解决办法是减去一个 基线(baseline) b(s):
∇θJ=E[t∑∇θlogπθ(at∣st)(Gt−b(st))]
为什么不引入偏差?因为对任何只依赖状态、不依赖动作的 b(s):
Ea∼πθ[∇θlogπθ(a∣s)b(s)]=b(s)a∑πθ(a∣s)πθ(a∣s)∇θπθ(a∣s)=b(s)∇θ=1a∑πθ(a∣s)=0
减去一个期望为 0 的项,不改变梯度的期望,却能大幅改变方差。这是强化学习里最优雅的技巧之一。
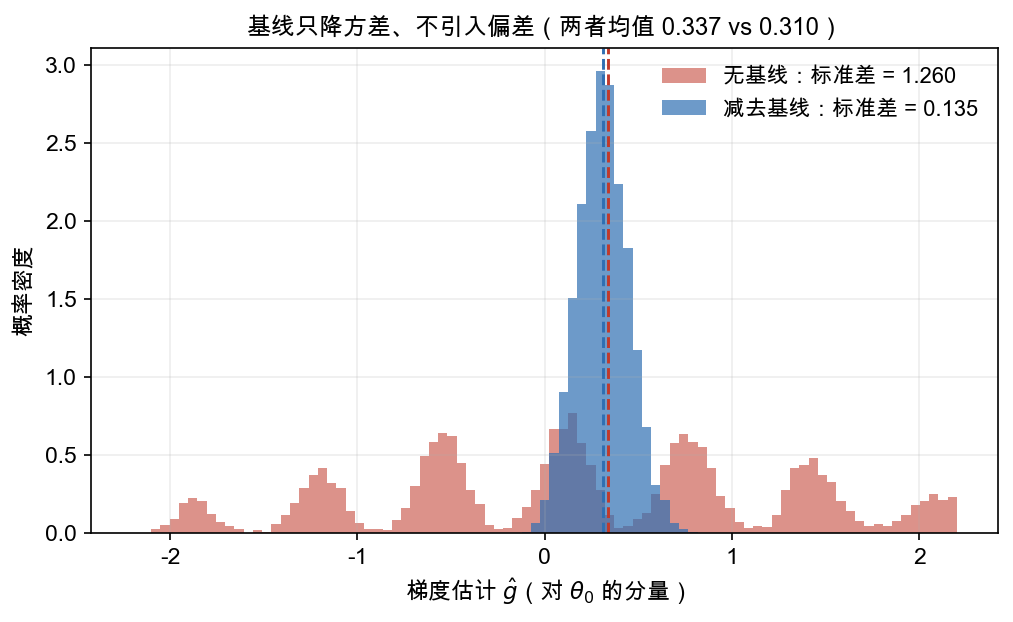
最自然的基线是 b(s)=V(s),此时括号里的东西正是优势函数:
Gt−V(st)≈A(st,at)
于是权重的含义从"这个动作带来了多少回报"变成了"这个动作比平均水平好多少"。好动作正权重、坏动作负权重,信号立刻变得干净。这也是第一篇里说"优势函数是把绝对数值变成相对比较"的意思。
优势估计:偏差-方差的连续谱
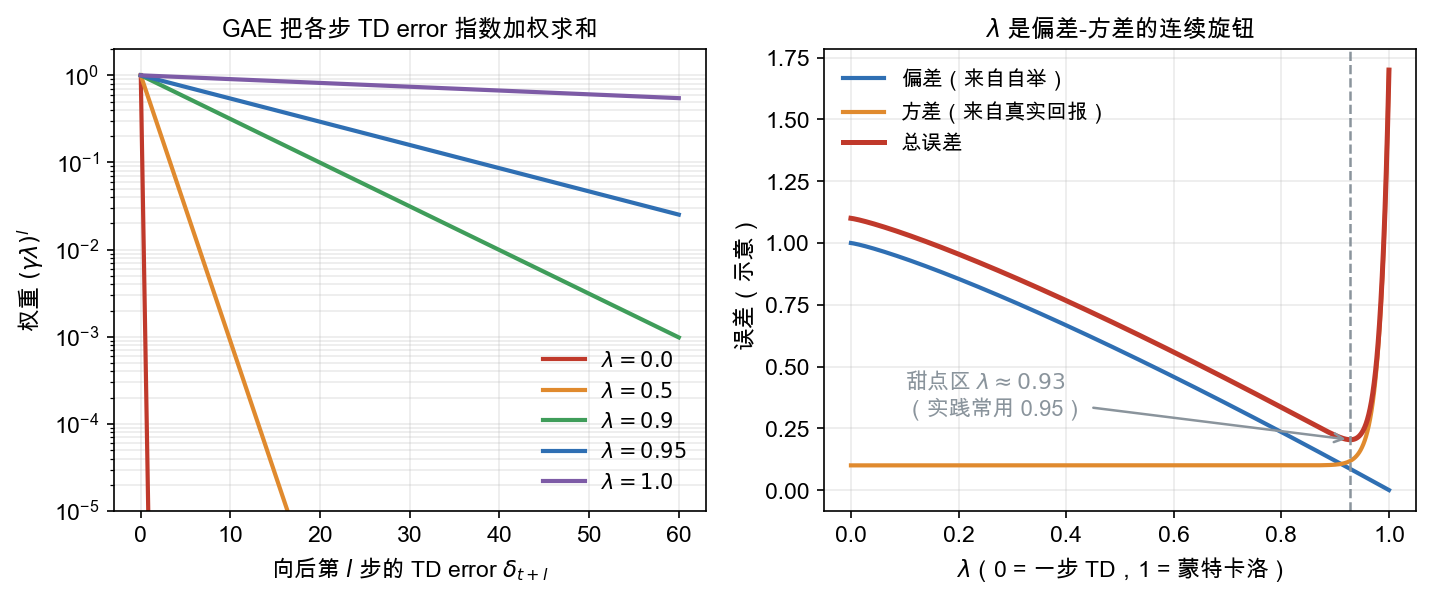
A 怎么估?有一系列选择,本质上是第二篇里 MC vs TD 权衡的重演:
A^t(1)=rt+γV(st+1)−V(st)(一步 TD,低方差高偏差)
A^t(n)=k=0∑n−1γkrt+k+γnV(st+n)−V(st)
A^t(∞)=Gt−V(st)(蒙特卡洛,无偏高方差)
GAE(Generalized Advantage Estimation) 的做法是把所有 n 的结果按 λ 指数加权平均,得到一个平滑的旋钮:
A^tGAE(γ,λ)=l=0∑∞(γλ)lδt+l,δt=rt+γV(st+1)−V(st)
λ=0 时退化为一步 TD,λ=1 时退化为蒙特卡洛。实践中 λ=0.95 附近几乎是所有 PPO 实现的默认值。计算上它可以从后往前一次扫描算完:
1
2
3
4
5
6
7
8
| def compute_gae(rewards, values, dones, gamma=0.99, lam=0.95):
adv, gae = [0.0] * len(rewards), 0.0
for t in reversed(range(len(rewards))):
not_done = 1.0 - dones[t]
delta = rewards[t] + gamma * values[t + 1] * not_done - values[t]
gae = delta + gamma * lam * not_done * gae
adv[t] = gae
return adv
|
Actor-Critic:把价值网络请回来
一旦引入 V(s) 作为基线,我们就需要一个网络去估它。这就是 Actor-Critic 架构:
1
2
3
4
5
6
7
8
9
| ┌──────────────────────────────────┐
│ 共享的特征提取层 │
└────────┬────────────────┬────────┘
│ │
┌───────▼──────┐ ┌──────▼───────┐
│ Actor 演员 │ │ Critic 评论家 │
│ π_θ(a|s) │ │ V_φ(s) │
│ 决定做什么 │ │ 评价做得如何 │
└──────────────┘ └──────────────┘
|
两个网络的更新目标不同:
Actor:∇θJ=E[∇θlogπθ(a∣s)A^]
Critic:ϕminE[(Vϕ(s)−G^)2]
Critic 的训练完全就是第二篇讲过的 TD 回归——两条路线在这里合流了。所以说 value-based 和 policy-based 并非对立,现代主流算法几乎全是 Actor-Critic 的变体。
A3C / A2C:用并行环境取代经验回放
Policy gradient 是 on-policy 的,不能用经验回放(旧数据来自旧策略)。那怎么解决样本相关性问题?A3C(Asynchronous Advantage Actor-Critic) 的答案是:同时开 16 个环境副本并行采集。同一时刻收集到的 16 个状态来自互不相干的环境实例,天然近似独立——用空间上的并行替代了 DQN 用时间上的回放来打破相关性。
A2C 是它的同步版本(等所有环境走完一步再统一更新),实现更简单、GPU 利用率更高,效果相当,因此更常用。
熵正则:给探索留一条路
前面说过,策略梯度只会强化已经做过的动作,因此容易过早收敛到确定性策略:某个动作偶然拿了几次高分,概率被推到 0.99,之后其他动作再也采不到,探索就死了。
解决办法是在目标里加一个熵奖励项:
J′(θ)=J(θ)+βEs[H(πθ(⋅∣s))],H(π)=−a∑π(a∣s)logπ(a∣s)
熵越大表示策略越随机。这一项相当于对"过于自信"施加惩罚,强制策略保持一定的随机性。β 是需要调的超参(Atari 上常用 0.01),太大则策略永远学不成型。监控策略的熵值是 policy gradient 训练中最有用的诊断指标之一:熵掉得太快,说明快要 collapse 了。
步长控制:从自然梯度到 PPO
为什么"学习率"在策略空间里不靠谱
这是理解 TRPO/PPO 的关键,值得单独讲清楚。
监督学习里,参数走一小步,函数变化也是一小步。但在 RL 里,参数空间的距离和策略行为的距离完全不成比例。举个具体例子:一个连续动作的高斯策略 πθ(a∣s)=N(μθ,σ2)。
- 如果 σ=1,把 μ 改变 0.1,策略行为基本没变(两个分布高度重叠)
- 如果 σ=0.01,把 μ 改变 0.1,新旧分布几乎完全不重叠,策略行为彻底改变
同样的参数改动量 0.1,造成的行为改变差了几个数量级。而 RL 的致命之处在于:策略一变,数据分布也跟着变。如果一次更新把策略推到一个很差的区域,接下来采到的数据全是垃圾数据,性能可能永久性崩塌,再也恢复不过来(监督学习里学习率大了顶多震荡,数据还在)。
结论:我们需要限制的不是参数的变化量,而是策略行为的变化量。
自然策略梯度
衡量两个分布的距离,自然的选择是 KL 散度。在参数邻域内做二阶近似:
KL(πθ∥πθ+Δθ)≈21Δθ⊤F(θ)Δθ
其中 F 是 Fisher 信息矩阵 F=E[∇logπθ∇logπθ⊤]。在"KL 距离固定"的约束下最速上升方向不是普通梯度,而是自然梯度:
∇~J=F−1∇θJ
它的几何意义是:在策略分布构成的空间里做最速上升,而不是在参数坐标里。这消除了参数化方式带来的任意性。问题是 F 的规模是参数量的平方,深度网络里根本无法显式构造和求逆。
TRPO:把它变成一个带约束的优化
TRPO(Trust Region Policy Optimization) 把上面的思想写成一个显式的约束优化问题。它先构造一个代理目标(surrogate objective),用重要性采样把"新策略的表现"用旧策略的数据表示出来:
θmaxEs,a∼πθold[πθold(a∣s)πθ(a∣s)A^(s,a)]s.t.Es[KL(πθold∥πθ)]≤δ
那个比值 rt(θ)=πθoldπθ 叫重要性比率。它的作用是让我们可以用旧策略采的数据来评估新策略——这也是 PPO 能对同一批数据做多轮梯度更新的原因(一定程度上的 off-policy)。
约束 KL≤δ 定义了一个"信任域":只在这个区域内相信代理目标是可靠的近似。TRPO 有一个漂亮的理论结果:在合适的惩罚系数下,可以保证策略单调改进。但它实现起来很痛苦——需要用共轭梯度法近似求解 F−1g,还要做线搜索。
PPO:用 clip 粗暴地实现信任域
PPO(Proximal Policy Optimization) 的洞察是:不必真的解约束优化,只要让"比率跑太远时梯度消失"就行。它的目标函数是:
LCLIP(θ)=E[min(rt(θ)A^t,clip(rt(θ),1−ϵ,1+ϵ)A^t)]
ϵ 通常取 0.1 或 0.2。这个 min 和 clip 的组合第一次看会觉得很怪,拆开看就清楚了:
| 情况 |
含义 |
clip 的作用 |
| A^>0,rt>1+ϵ |
好动作,概率已提高很多 |
截断,不再给梯度(防止一次推太猛) |
| A^>0,rt<1+ϵ |
好动作,还没提太多 |
正常给梯度 |
| A^<0,rt<1−ϵ |
坏动作,概率已压低很多 |
截断,不再给梯度 |
| A^<0,rt>1−ϵ |
坏动作,还没压下去 |
正常给梯度(且不设上限,可以大力压) |
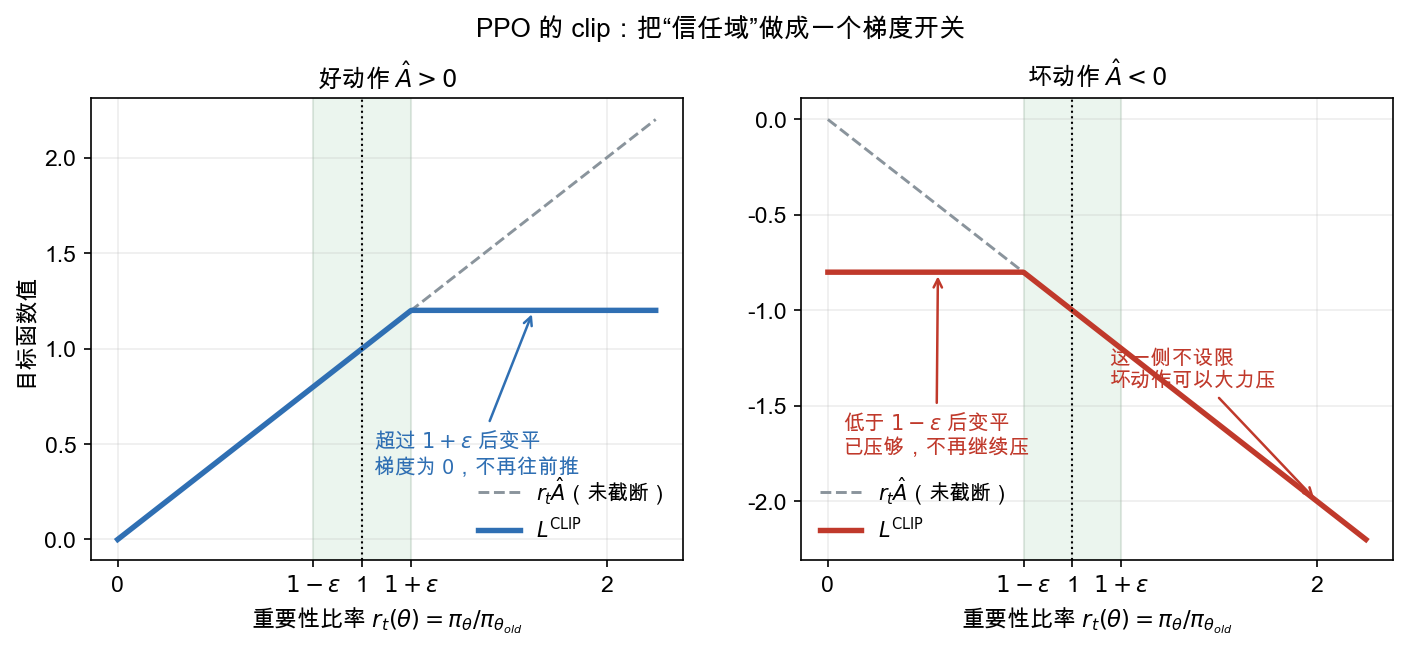
外层的 min 保证我们取的是悲观(更小)的那一个估计,这使得目标成为真实目标的一个下界,优化它是安全的。
完整的 PPO 损失还包括价值损失和熵项:
L=−LCLIP+c1critic 损失E[(Vϕ(s)−G^)2]−c2熵奖励E[H(πθ)]
核心实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| def ppo_loss(policy, value_net, batch, clip_eps=0.2, c1=0.5, c2=0.01):
s, a, logp_old, adv, ret = batch
adv = (adv - adv.mean()) / (adv.std() + 1e-8)
logp = policy.log_prob(s, a)
ratio = torch.exp(logp - logp_old)
unclipped = ratio * adv
clipped = torch.clamp(ratio, 1 - clip_eps, 1 + clip_eps) * adv
policy_loss = -torch.min(unclipped, clipped).mean()
value_loss = F.mse_loss(value_net(s), ret)
entropy = policy.entropy(s).mean()
return policy_loss + c1 * value_loss - c2 * entropy
|
训练循环的结构是:采一批数据 → 用它做 K 轮(通常 3~10)小批量梯度更新 → 丢掉,重新采。K 不能太大,否则 rt 偏离 1 太远,代理目标失效。
实现细节决定成败
有一篇著名的研究指出:PPO 相对 TRPO 的性能提升,很大一部分来自那些论文里没强调的实现细节,而不是 clip 本身。所以这些必须知道:
| 细节 |
做法 |
影响 |
| 优势归一化 |
每个 batch 内标准化到零均值单位方差 |
很大,几乎必需 |
| 观测归一化 |
用滑动均值方差标准化状态 |
连续控制任务上很大 |
| 奖励缩放 |
用回报的滑动标准差缩放 |
较大 |
| 学习率退火 |
线性衰减到 0 |
中等 |
| 正交初始化 |
policy 输出层用小增益(如 0.01) |
中等,防止初期动作过激 |
| 梯度裁剪 |
全局范数裁到 0.5 |
中等 |
| 价值损失裁剪 |
类似 policy 的 clip |
小,有争议 |
| 独立还是共享网络 |
连续控制任务上常独立更好 |
视任务 |
连续控制的主力:确定性策略与最大熵
PPO 是 on-policy 的,样本效率不高。在真机控制等交互昂贵的场景,我们希望像 DQN 一样复用回放池。这就引出了 off-policy 的 Actor-Critic 家族。
DPG / DDPG:让网络去算 argmax
回到本文开头的问题:连续动作下 argmaxaQ(s,a) 不可解。确定性策略梯度(DPG) 的做法极其直接:训练一个网络 μθ(s) 专门去输出这个 argmax。
既然 Q 对动作可微(神经网络嘛),那就让 μθ 沿着"能让 Q 变大"的方向走,用链式法则:
∇θJ=Es∼D[∇aQ(s,a;ϕ)a=μθ(s)⋅∇θμθ(s)]
对比一下两种策略梯度,差别很清楚:
|
随机策略梯度 |
确定性策略梯度 |
| 梯度形式 |
E[∇logπ⋅A] |
E[∇aQ⋅∇θμ] |
| 需要对什么求期望 |
状态和动作 |
只对状态 |
| 方差 |
高 |
低 |
| on/off-policy |
通常 on-policy |
off-policy |
| 探索来源 |
策略自身的随机性 |
必须外加噪声 |
DDPG(Deep DPG) 就是把这个思路配上 DQN 的全套工程装备:经验回放 + 目标网络(软更新)+ 批归一化,探索靠在输出动作上加噪声(原论文用 Ornstein-Uhlenbeck 过程,后来发现高斯噪声一样好)。它一度是连续控制的标准方法,但极其难调、对超参敏感、容易发散。
TD3:把第二篇的教训搬过来
DDPG 不稳定的核心原因,其实就是第二篇讲过的 Q 值过估计——而且这里更严重,因为 μθ 会主动去寻找 Q 函数被高估的那些动作,形成一个"策略去攻击 critic 的错误"的恶性循环。TD3 给出三个针对性的补丁:
- 双 critic 取最小(Clipped Double Q-learning):训两个 critic,标签用 min(Qϕ1,Qϕ2)。这是一种刻意的悲观,用一点低估换掉危险的高估。
- 目标策略平滑:算标签时在目标动作上加一点噪声 a′=μθ−(s′)+clip(ϵ,−c,c)。这相当于让 Q 在动作维度上变平滑,防止策略钻进一个尖锐的虚假峰值。
- 延迟策略更新:critic 更新几次,actor 才更新一次。让 critic 先稳下来,再让 actor 去信任它。
三条改动都很朴素,效果却很显著。注意它们都可以追溯到第二篇的 Double DQN 思想——这就是把两条路线一起理解的价值。
SAC:最大熵 RL
SAC(Soft Actor-Critic) 换了个更根本的思路:修改优化目标本身,把熵直接写进去:
J(π)=E[t∑γt(rt+αH(π(⋅∣st)))]
也就是"在拿到高回报的同时,尽可能保持随机"。这不只是加个正则项那么简单,它带来一系列好处:
- 探索是内生的、自动的,不需要外加噪声调度
- 策略倾向于覆盖所有近似最优的行为模式,而不是死磕一个,因此对环境扰动更鲁棒
- 在这个目标下,贝尔曼方程变成 soft 版本,max 被 softmax(log-sum-exp)替代,处处可微
对应的 soft 价值函数满足:
Q(s,a)=r+γEs′soft V(s′)Ea′∼π[Q(s′,a′)−αlogπ(a′∣s′)]
策略更新则是最小化与 Boltzmann 分布 ∝exp(Q/α) 的 KL 散度。实现上有两个关键技巧:
- 重参数化(reparameterization):a=tanh(μθ(s)+σθ(s)⊙ε),ε∼N(0,I)。这样梯度可以直接穿过采样过程回传(低方差),而不必用 log-derivative trick(高方差)。tanh 用来把动作压到有界区间,需要相应修正 log 概率。
- 自动温度调节:α 很难手调,且在训练不同阶段需要不同值。SAC 把它变成一个约束优化问题——要求策略熵不低于一个目标值 Hˉ,然后对 α 做梯度下降自动调节。
SAC 目前是连续控制任务上最可靠的默认选择:样本效率高(off-policy)、超参不敏感、不需要调噪声。
统一视角
到这里,"value-based"和"policy-based"的界限已经相当模糊了。整理一下这个谱系:
| 算法 |
on/off-policy |
策略类型 |
步长控制 |
主要场景 |
| REINFORCE |
on |
随机 |
无 |
教学 |
| A2C / A3C |
on |
随机 |
无(靠小学习率) |
离散、并行环境多 |
| TRPO |
on |
随机 |
KL 硬约束 |
需要稳定性保证 |
| PPO |
on(近似) |
随机 |
clip 软约束 |
通用默认选择、RLHF |
| DDPG |
off |
确定性 |
软更新 |
连续控制(已过时) |
| TD3 |
off |
确定性 |
软更新 + 悲观 |
连续控制 |
| SAC |
off |
随机(最大熵) |
软更新 + 熵约束 |
连续控制默认选择 |
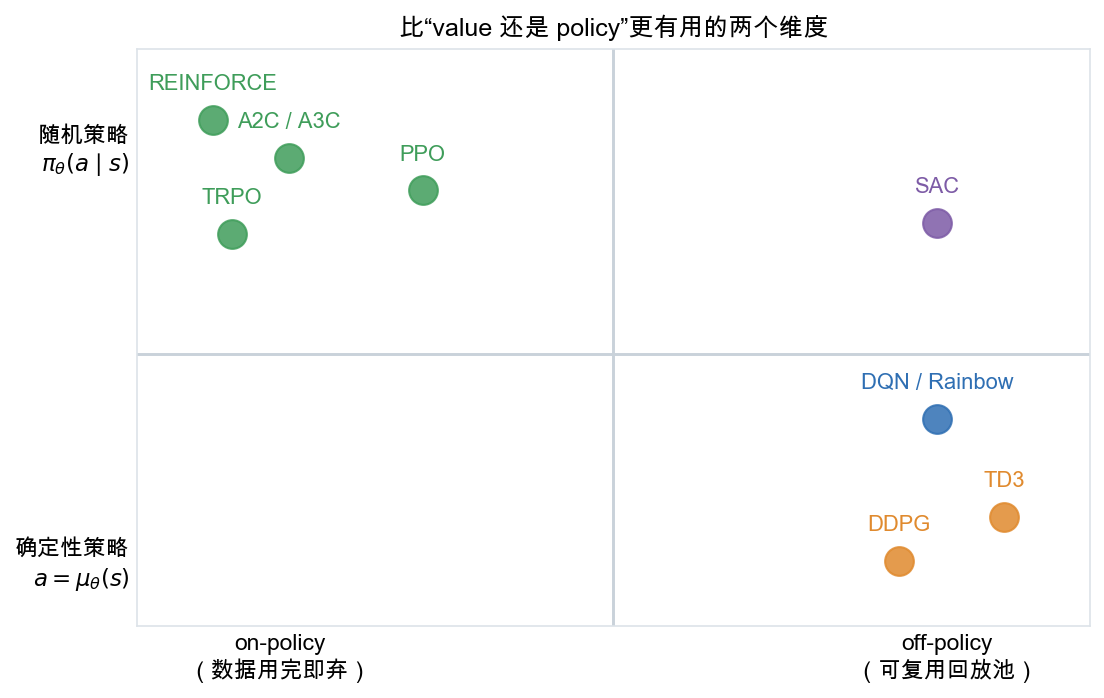
更深一层看,两条路线在数学上是可以互相翻译的:
- Soft Q-learning 证明了最大熵 RL 里的"最优策略"就是 π(a∣s)∝exp(Q(s,a)/α)。也就是说,学一个 soft Q 函数和学一个策略是等价的,SAC 可以同时被看作 value-based 和 policy-based 方法。
- PGQ / Q-Prop 等工作显式地把策略梯度和 Q-learning 的更新混合,用一个系数在两者间插值。
所以更有用的分类维度不是"value 还是 policy",而是:是否 off-policy(能否复用数据)× 策略是否随机 × 如何控制更新幅度。
落到当下:RLHF 与 GRPO
策略梯度方法今天最大规模的应用,是训练大语言模型。这里把对应关系写清楚:
| RL 概念 |
在 LLM 训练中对应什么 |
| 策略 πθ |
语言模型本身 |
| 状态 st |
prompt + 已生成的 token 序列 |
| 动作 at |
下一个 token(动作空间 = 词表,约 105) |
| 回合结束 |
生成 EOS 或达到长度上限 |
| 奖励 r |
奖励模型(reward model)对完整回答的打分 |
| 约束 |
与初始 SFT 模型的 KL 惩罚 |
RLHF 的标准流程是:SFT(监督微调)→ 训练奖励模型(用人类偏好对比数据)→ 用 PPO 优化策略。目标函数长这样:
θmaxE[rRM(x,y)−βKL(πθ(y∣x)∥πSFT(y∣x))]
这里出现了两个 KL,别搞混:
- PPO 内部的 clip / KL:限制单次更新的幅度,是优化稳定性手段
- 与 SFT 模型的 KL 惩罚:防止奖励作弊(reward hacking)——奖励模型是个不完美的代理,策略如果跑得离原始分布太远,就会找到那些"骗过奖励模型但实际很糟"的输出(比如疯狂输出某些讨好的句式)
为什么这里 PPO 很别扭?它需要一个和策略同规模的 critic 网络来估 V(s),即"当前生成到一半时,这段回答最终能得几分"。这意味着显存里要同时放 4 个大模型(policy、critic、reward model、reference model),而且这个 critic 本身很难训准——奖励只在序列末尾出现一次,中间所有 token 的价值都要靠自举估计。
GRPO 的思路是干脆把 critic 去掉。既然基线的作用只是"提供一个比较的参照点",那就用同一个 prompt 采样一组(group)回答,用组内的平均得分当基线:
A^i=std(r1,…,rG)ri−mean(r1,…,rG)
这本质上就是回到了 REINFORCE + 蒙特卡洛基线,用组内采样的方差换掉了 critic 的偏差和显存开销。在数学推理这类"答案可自动验证、奖励可靠"的任务上效果很好——这也再次说明,REINFORCE 那些"过时"的思想在合适的场景下会重新变得最优。
调参优先级
如果 PPO 跑不起来,按这个顺序检查:
- 优势归一化有没有做(最常见的遗漏)
- 观测/奖励是否归一化(连续控制任务上不做基本学不动)
- 监控策略熵:掉太快 → 加大熵系数;一直不降 → 熵系数太大或学习率太小
- 监控 KL 或 clip 比例:clip 触发比例应在 10%~30% 之间。过高说明学习率太大或 K 轮太多
- GAE 的 λ:先试 0.95,任务视野长可调高
- γ 与任务视野是否匹配(第一篇说过,它是偏差-方差旋钮)
- 网络别太大:RL 里过大的网络经常反而更差
- 多跑几个随机种子:RL 的种子间方差极大,单次实验的结论基本不可信
小结
- 策略梯度直接对 J(θ)=E[G] 求梯度,通过 log-derivative trick 得到 ∇J=E[∇logπθ⋅G],环境动力学在求导时自动消失——不需要模型。它的形式是"用回报加权的最大似然"。
- 头号敌人是方差。三个层层递进的解法:只用未来回报(因果性)、减去基线(不引偏差)、用优势函数与 GAE(连续调节偏差-方差)。基线引入了 critic,于是有了 Actor-Critic 架构,两条路线在此合流。
- 第二个敌人是步长:参数距离 = 策略距离,而策略一变数据分布也变,一次过大的更新可能造成不可恢复的崩塌。自然梯度用 Fisher 矩阵在分布空间做最速上升,TRPO 写成 KL 约束优化,PPO 用 clip 粗暴而高效地近似同一件事。
- 连续控制走另一条支线:DDPG 训一个网络去算 argmaxaQ,TD3 用双 critic 取最小、目标平滑、延迟更新修掉过估计(思想直接来自 Double DQN),SAC 把熵写进目标从而让探索内生化,成为当前最可靠的默认选择。
- 大模型的 RLHF 正是这条路线的最大规模应用;GRPO 用组内相对优势替代 critic,是"REINFORCE + 基线"思想的回归。
至此我们讲完了两类 model-free 方法:它们都不去理解环境本身,只是从大量试错中总结规律。这也是它们样本效率低的根本原因——PPO 在一个简单的机器人任务上可能需要百万级交互步数,而人类学开车不需要撞一万次。因为我们脑子里有一个"世界模型",可以先在想象中试。
下一篇 Model-based methods:把环境的动力学学出来,然后在模型里规划和想象。我们会讲 MCTS 与 AlphaZero/MuZero 如何把搜索与神经网络结合、世界模型(World Models、Dreamer)如何在隐空间里做梦,以及模型误差这个绕不开的核心矛盾。
